
OmniTalker
 1.87w
 0
 0
OmniTalker是阿里通义实验室开发的一款基于深度学习和多模态融合技术的新型数字人视频生成大模型。它能够通过上传一段参考视频,实现对视频中人物的表情、声音和说话风格的精准模仿,从而生成高度逼真的数字人视频。
直达网站
OmniTalker是什么?
OmniTalker是阿里通义实验室开发的一款基于深度学习和多模态融合技术的新型数字人视频生成大模型。它能够通过上传一段参考视频,实现对视频中人物的表情、声音和说话风格的精准模仿,从而生成高度逼真的数字人视频。
主要亮点
- 精准模仿能力:OmniTalker能够捕捉到参考视频中人物的细微表情和声音特点,生成与之高度相似的音视频内容,让人难以分辨真假。
- 降低成本:相较于传统的数字人制作流程,OmniTalker显著降低了制作成本,使得更多用户能够轻松拥有高质量的数字人服务。
- 增强真实感与互动体验:生成的音视频内容真实感极强,且由于能够精准模仿人物的声音和说话风格,为用户提供了更加自然、流畅的互动体验。
模型优势
- 多模态融合:OmniTalker实现了音频、视频和文本的多模态融合,使得生成的数字人更加生动、立体。
- 高效处理:模型采用先进的算法和架构,能够高效处理大量数据,快速生成高质量的音视频内容。
- 零样本学习:OmniTalker具备零样本学习能力,只需一段参考视频即可生成新的数字人视频,无需额外训练数据。
需求人群
- 内容创作者:如视频博主、主播等,可以利用OmniTalker快速生成高质量的数字人视频内容。
- 企业用户:企业可以利用OmniTalker制作虚拟客服、虚拟代言人等数字人形象,提升品牌形象和用户体验。
- 教育机构:教育机构可以利用OmniTalker制作虚拟教师、虚拟助教等数字人形象,为学生提供更加生动、有趣的学习体验。
适用场景
- 虚拟主播:利用OmniTalker生成虚拟主播形象,进行直播、录播等节目制作。
- 虚拟客服:企业可以利用OmniTalker制作虚拟客服形象,为用户提供24小时不间断的在线服务。
- 游戏与娱乐:在游戏和娱乐领域,OmniTalker可以生成虚拟角色形象,为玩家提供更加沉浸式的游戏体验。
使用便捷性
OmniTalker的使用非常简便。用户只需在平台上上传一段参考视频,选择相应的模板和参数设置,即可快速生成与之同步的音频和视频内容。目前,该项目已在魔搭社区和HuggingFace等平台开放体验,并提供了详细的教程和示例视频供用户参考。
OmniTalker如何使用
- 注册与登录:用户需要访问OmniTalker的官方网站或相关平台(如魔搭社区、HuggingFace等)进行注册和登录。
- 上传参考视频:在平台上上传一段清晰的参考视频,确保视频中的人物表情、声音和说话风格清晰可辨。
- 选择模板与参数:根据需求选择合适的模板和参数设置,如视频分辨率、帧率、音频质量等。
- 生成与导出:点击生成按钮,等待模型处理完成后即可导出生成的音视频内容。
技术背景与突破
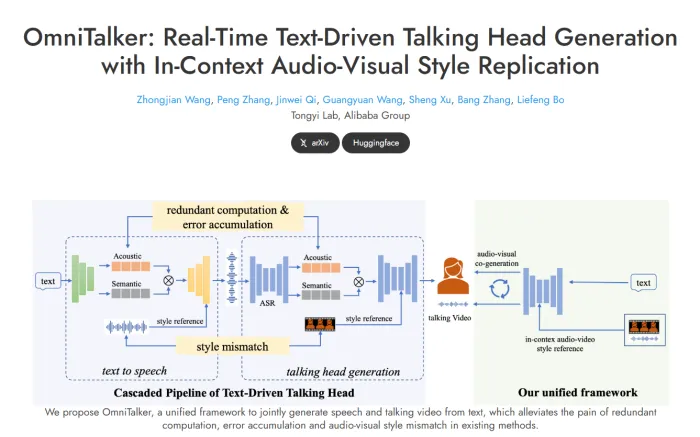
近年来,随着语言大模型和生成式AI的迅猛发展,虚拟主播和虚拟助手的应用越来越广泛。然而,传统的文本驱动数字人生成研究相对较少,且存在音画不同步、说话风格不一致等问题。OmniTalker通过引入双分支DiT架构和多模态特征融合技术,成功克服了这些技术瓶颈,实现了从文本和参考视频中同时生成同步的语音和视频。
模型结构与创新
OmniTalker的模型结构由三大核心部分构成:
- 特征提取模块:负责提取音频特征和视觉特征,并确保两者在时间上的完美同步。
- 多模态特征融合模块:将音频特征和视觉特征进行融合,提升音视频内容的整合效果。
- 解码器模块:经过预训练的解码器能够高效将合成的音视频特征转换为原始格式,保证输出的高质量。
此外,OmniTalker还采用了先进的Flow Matching训练技巧和优化算法,进一步提升了模型的性能和生成效果。
实验数据与表现
通过实验数据的对比和分析,OmniTalker在音频生成和视觉效果方面都表现出色。它显示出更低的错误率、更高的声音相似度和更逼真的视觉效果。特别是在零样本条件下,OmniTalker依然能够保持出色的生成效果,进一步证明了其强大的泛化能力和实用性。
未来发展
总的来说,阿里通义实验室推出的这款OmniTalker模型无疑是数字人生成领域的一大创新。它不仅降低了制作成本、提升了生成内容的真实感和互动体验,还为用户提供了更加简便、高效的使用方式。随着技术的不断进步和应用场景的不断拓展,相信OmniTalker将会在更多领域得到广泛应用,并为用户带来更加丰富的数字人体验。未来,我们期待OmniTalker能够继续引领数字人生成领域的发展潮流,为人工智能技术的进步贡献更多的力量。
评论
全部评论

暂无评论
热门推荐


相关推荐

Sec-Gemini v1
Sec-Gemini v1是谷歌基于其Gemini模型构建的一款全新AI安全模型。它集成了Gemini的先进推理能力,并结合了近乎实时的网络安全知识和工具,旨在帮助网络安全专业人员更有效地应对网络威胁,提升威胁情报分析、漏洞理解和事件响应的效率。
Signature AI
Signature AI,一家领先的私有AI人工智能服务提供商,致力于帮助企业构建专注于安全、保障和知识产权增长的私有AI模型,同时确保卓越的输出质量。以下是对Signature AI的详细介绍。
模力指数GEO
模力指数GEO是一款面向大模型时代的品牌监测产品,通过持续分析主流AI模型中的数据,从提及度、认知准确度、推荐度、情感倾向和竞争对比五个维度,量化品牌在生成式AI环境中的认知表现。该产品提供定制看板、趋势洞察与竞品分析,帮助企业发现AI语境下的认知盲区与风险,为品牌优化提供数据支持.
Ming-Omni
Ming-Omni是由Inclusion AI与蚂蚁集团联合推出的开源多模态模型,其核心亮点在于统一处理图像、文本、音频和视频,并支持语音与图像生成,成为首个在模态支持能力上与GPT-4o媲美的开源模型。
Babel
Babel是阿里巴巴达摩院推出一款专为多语言处理而设计的开源大型语言模型。不仅支持全球使用人数最多的前 25 种语言,覆盖超 90% 的世界人口,它还将触角伸向了斯瓦希里语、爪哇语、缅甸语这类在开源大语言模型(LLM)领域鲜有人问津的语种。这一极具前瞻性的行动,势必将为数十亿以这些语言服务
紫东太初大模型
紫东太初大模型是由中国科学院自动化研究所与武汉人工智能研究院联合研发,是全球领先的跨模态通用人工智能平台,也是一个千亿参数级别的多模态大模型,它能够实现文本、图像、音频、视频、传感信号和3D点云等多种数据模态的统一表示和互相生成。
Happy Oyster
Happy Oyster是阿里巴巴自研的开放式世界大模型,专注解决AI视频时长短、画面抖动、逻辑断层、人物崩坏等痛点。文本一键生成影视级画质长视频,支持台词匹配、镜头运镜、场景转场,人物五官高度一致,剧情逻辑完整流畅。覆盖AI短剧、宣传片、IP内容等全场景创作,助力创作者和影视团队低成本、高效率
炉米Lumi
炉米Lumi是由字节跳动推出的一个AI模型分享社区平台,旨在满足日益增长的AI模型交流与应用需求。该平台由字节跳动内部孵化,定位为一个融合模型分享、工作流搭建和模型训练的综合性平台,旨在促进AI技术在各个领域的广泛应用和深入发展。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴