一句话看懂这件事:不用再去 DeepSeek 官方单独对接接口,现在在千问 AI 平台,就能直接调用最新的 V4.1-Flash 了。
9 月 14 日,阿里云宣布,DeepSeek-V4.1-Flash 正式上线千问 AI 平台,相关 API 服务与 Token Plan 同步开放。
对开发者来说,这是一次很实在的「生态打通」——过去想用这款模型,得单独对接 DeepSeek 官方接口;现在依托阿里云百炼,一套接口、一个控制台,就能直接调用了。
一款「更聪明、更快、更省」的小模型
DeepSeek-V4.1-Flash 是 DeepSeek 在 9 月 10 日发布的最新多模态大模型,也是它新一代架构家族里「最小」的那一个。
但它小,不代表弱。三个关键词概括它:更聪明、更快、更省。
模型采用 552B 参数的 MoE(混合专家)架构,创新性地设计了「输入输出不对称激活」机制——输入理解阶段只激活 8B 参数,输出生成阶段激活 16B 参数。这样大量需要反复上传上下文的场景(比如智能体、知识库问答),调用成本直接大幅下降。
更关键的是它对长上下文场景的优化:新一代 KV 缓存压缩技术,把 HBM 显存需求降到上一代的 1/4,SSD 存储需求降到 1/8。在长任务、高频调用场景下,算力开销显著降低。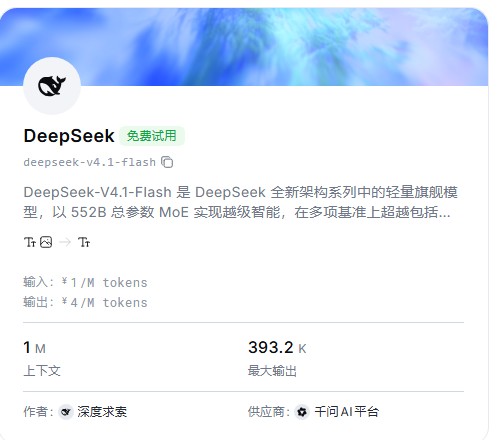
原生多模态,不用外挂视觉模块
V4.1-Flash 原生支持文本与图像理解,最长支持 100 万 Token 上下文。
这意味着你不需要外挂额外的视觉处理模块,直接上传图片,模型就能完成图片内容识别、图文结合推理。适合的场景包括:文档扫描识别、工业视觉质检辅助、图文混合内容处理等。
官方定位的四大应用场景也很清楚:代码开发、长文档处理、视觉理解、智能体任务。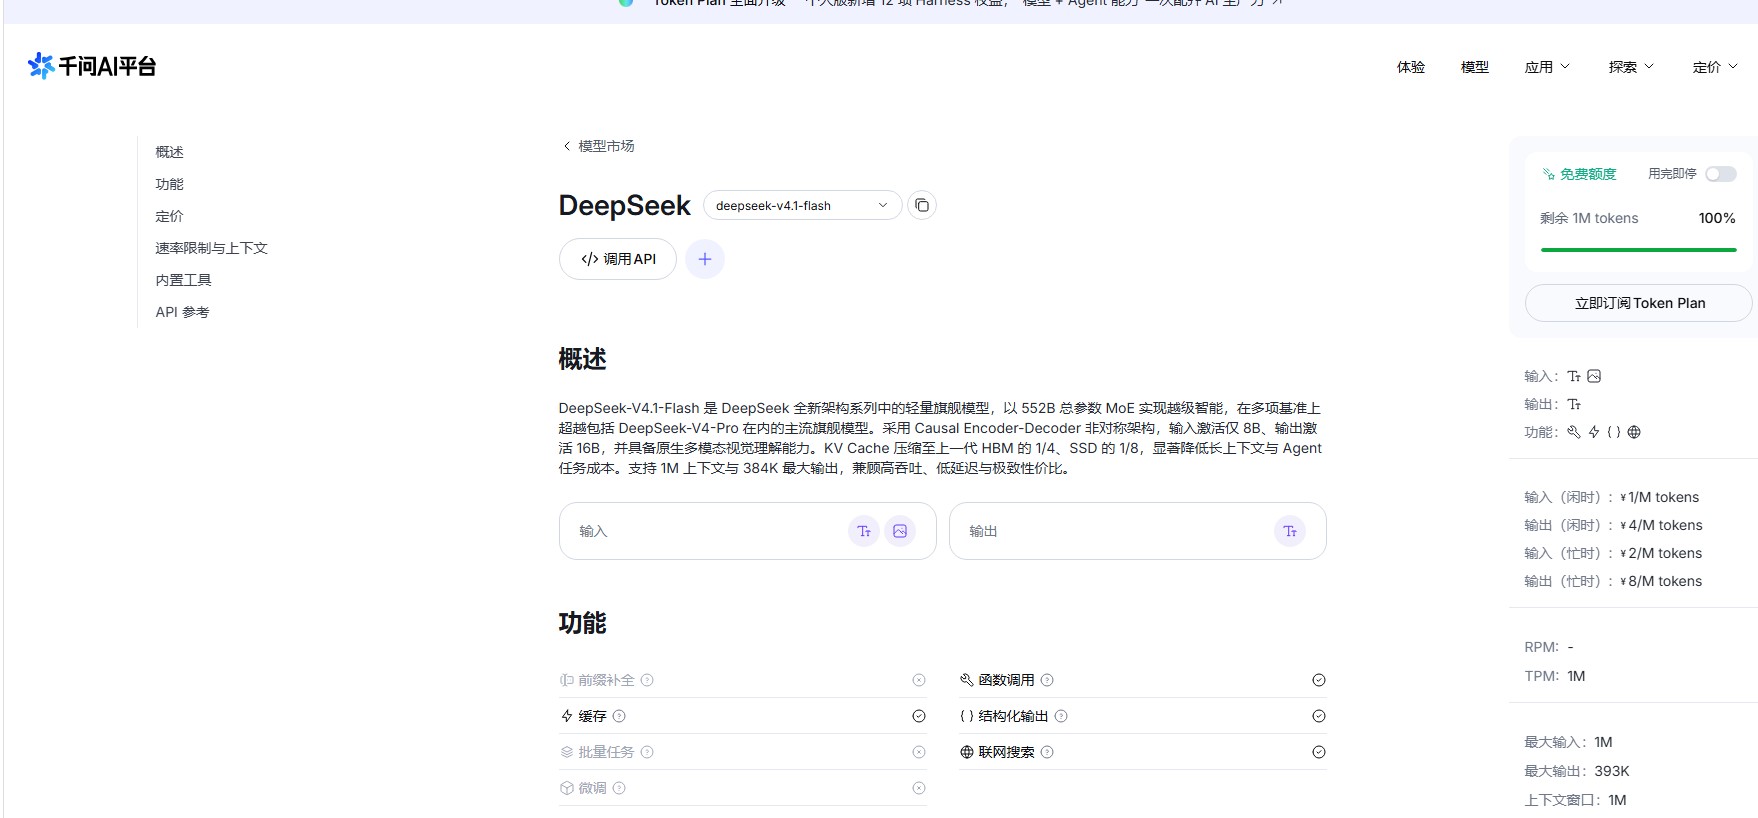
开发者真正得到的三样东西
这次接入,对开发者的实际价值,可以拆成三点:
一是省心。 不用再对接多套 API 接口、管理多套账户和计费规则。在千问平台的统一开发环境里,就能调用 V4.1-Flash 的全部能力,还能和平台上的通义千问系列模型无缝切换,一套开发框架适配不同模型。
二是省钱。 Token Plan 支持按 Credits 统一计量,开发者可以根据业务规模选资源包。而且 DeepSeek-V4.1-Flash 本身就走的是「高性能 + 低成本」路线,还支持按量付费。
三是省事。 阿里云百炼配套的全套工具链——模型微调、Prompt 调试、应用快速搭建——都能直接对接这款模型,不用从零搭建开发环境。
一次「开源社区 + 云厂商」的协同
这次上架背后,有个细节值得一提:模型上架是阿里云百炼与 vLLM 开源社区协同完成的。
基于 vLLM 对 V4.1-Flash 的快速适配,阿里云完成了模型部署并开放服务。这也是开源模型生态和云厂商之间一次典型的协作——开源社区负责把推理跑通,云厂商负责把它变成稳定的 API 服务,让海量开发者能低成本用上。
DeepSeek 官方也明确表态,会继续和开源社区合作,探索更多部署选项。所以这次上架,不只是「多了一个模型」,更是一个信号:开源模型正在通过云 API,持续进入真实业务场景。
结语
放在国内 AI 行业的大背景下看,这件事的走向很清晰:模型平台化、多模型聚合,正在成为趋势。
过去开发者想测不同厂商的模型,得注册多个平台、管理多套密钥、适配不同接口。现在阿里云、火山引擎这些云厂商,都在把多家开源模型统一封装成 API,统一计费。
对中小开发者和 AI 创业团队来说,最大的价值是「试错成本下降」——可以快速对比不同模型在代码、长文档、Agent 任务上的表现,按需选用套餐,不用一次性投入高额算力搭私有环境。
当然,生态竞争也随之加剧。平台方要比模型丰富度、推理稳定性、价格;模型厂商则借云平台触达海量开发者。但不管怎么卷,对开发者来说,「能用上」和「用得起」的模型越多,总是好事。