
Waver
 1.68w
 0
 0
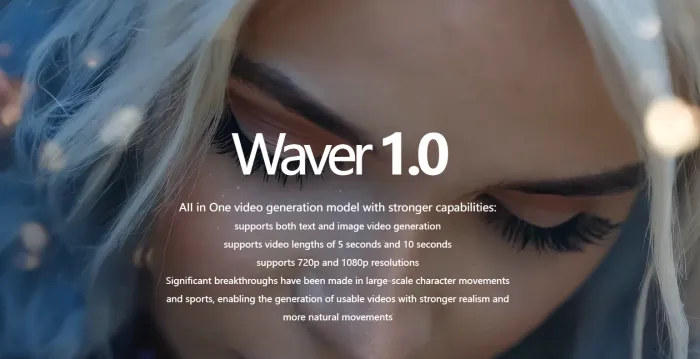
Waver是由Foundation Vision团队开源的通用视频生成大模型,它把文本-视频(T2V)、图像-视频(I2V)、多机位叙事、长时长高分辨率生成等能力整合到同一套权重里,无需额外微调即可直接输出5 s / 10 s、720 p / 1080 p的成品视频。
直达网站

一、Waver是什么?
Waver是由Foundation Vision团队开源的「All-in-One」通用视频生成大模型,官方口号是 “Make your creativity groundbreaking”。它把文本-视频(T2V)、图像-视频(I2V)、多机位叙事、长时长高分辨率生成等能力整合到同一套权重里,无需额外微调即可直接输出5 s / 10 s、720 p / 1080 p的成品视频。
二、模型性能:
Artificial Analysis(2025-08-05 19:00 GMT+8)公开排行榜:Waver 1.0在运动质量、视觉质量、Prompt Following三项均位列第一,超越Runway Gen-4、Pika 2.0、Stable Video Diffusion等开源/闭源对手。
自建评测集
- Waver-Bench 1.0:覆盖 1200+ 组复杂动作、光影、风格化prompt。
- Hermes Motion-Testset:聚焦大规模人体与动物运动,人工盲评显示 Waver 领先第二名 18 %。
三、核心功能
文本-视频:
- 亮点:单句prompt 直接出片
- 示例效果:“雨中玻璃罐里微型世界”——雨滴、蘑菇咖啡馆、小人撑伞,细节全部对齐
图像-视频:
- 亮点:任意静图「活」起来
- 示例效果:把一张帆船照片变成半水下视角的10 s航行片段
多机位叙事:
- 亮点:原生支持镜头切换,角色/场景/光场一致
- 示例效果:老工匠完工:近景手部→特写眼睛→全景工作室→情绪收束,4镜一气呵成
长时长输出:
- 亮点:最长 10 s 连续片段,情感动作更完整
- 示例效果:企鹅百米冲刺:起跑、加速、撞线、减速,动作物理合理
高分辨率:
- 亮点:1080 p 原生,无需后超分
- 示例效果:城市夜景+烟花航拍,灯牌文字清晰可辨
多艺术风格:
- 亮点:写实、动漫、黏土、毛绒、赛博朋克、Wes Anderson 等一键切换
- 示例效果:王家卫复古滤镜+可口可乐机,胶片颗粒与霓虹光斑精准还原
运动皇冠:
- 亮点:人物/动物体育动作
- 示例效果:大熊猫花样滑冰、老虎高山滑雪、袋鼠拳击,关节轨迹真实
四、需求人群
- 创意工作室:广告片头、MV、概念 PV 快速预演。
- 自媒体 & MCN:低成本生成高质感短视频,批量起号。
- 影视动画:分镜预览、特效预合成、风格探索。
- 教育与培训:医学/体育/军事等需要人体动态演示的场景。
- 电商 & 零售:商品 360° 动态展示、虚拟试穿。
- 独立开发者:开源可商用,二次开发门槛低。
五、应用场景
- 广告创意:24K 金杏坠落慢动作 + 液体飞溅,一条 5 s 片头直接投放 TikTok Ads。
- 文旅宣传:输入一张古镇照片,生成“晨雾+花瓣雨+游船穿梭”的 10 s 竖屏短片。
- 动画分镜:导演一句“赛博曼谷飞狗出租车”,30 秒出 4 镜连贯故事板。
- 体育教学:生成“托马斯全旋”第一人称视角,配合骨骼标注用于动作拆解。
- 虚拟偶像:毛绒风格偶像在黏土世界开演唱会,跨次元联动。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区
AITOP100平台官方交流社群二维码:

评论
全部评论

暂无评论
热门推荐


相关推荐

SongGeneration
SongGeneration是腾讯AI Lab正式推出并开源的一款音乐生成大模型。它旨在解决音乐生成领域中普遍存在的音质、音乐性和生成速度等三大难题,通过先进的技术架构和算法,实现高质量音乐作品的自动创作。
Seele AI
Seele AI是由全灵(深圳)人工智能有限公司推出的全球首个端到端AI生成3D游戏的多模态大模型,它以自然语言为驱动,支持文本、语音、图片、视频等多模态输入,可一键生成包含角色、场景、玩法逻辑、物理规则、动画音效等全要素的完整3D游戏世界,实现“零代码”创作与动态迭代优化。
Video-XL-2
Video-XL-2是智源研究院联合上海交通大学等机构于2025年6月发布的超长视频理解模型,其核心突破在于单张显卡即可处理万帧级视频输入(约1小时时长的30FPS视频),同时保持轻量化设计(参数规模远低于720亿参数的闭源模型)。
Flex.2-preview
Flex.2-preview是由Ostris团队发布的一款基于8亿参数的文本到图像扩散模型,专为集成到ComfyUI工作流设计。该模型在Hugging Face上开源,采用Apache2.0许可证,凭借其强大的控制能力与高效生成特性,迅速成为AI艺术创作社区的焦点。
Fabric 1.0
VEED Fabric 1.0是VEED.IO 推出的全球首款AI会说话视频模型,它实现了从静态图像到动态叙事的重大跨越,仅需一张图片结合语音输入,就能生成最长1分钟、具备逼真唇形同步和自然面部表情的会话视频。该模型专为“talking head”视频设计,生成速度极快,成本大幅降低,还集成多种生态
K2 Think
K2 Think是阿联酋穆罕默德·本·扎耶德人工智能大学与科技集团G42联合推出的开源大语言模型(LLM),以320亿参数的紧凑架构实现性能跃迁,在数学、科学等复杂推理任务中超越参数规模大20倍的旗舰模型,重新定义了高效推理的技术边界,自称为全球最快的开源AI模型和最先进的开源AI推理系统
AudioStory
AudioStory模型是腾讯ARC实验室推出的一款开源音频模型,该模型用大语言模型生成长音频,通过创新的“分而治之”策略与双通道解耦机制,解决了长音频生成中的逻辑与情感断层问题,实现了电影级音频的智能生成与续写,并正以开源策略推动AI音频叙事领域的技术革新。
天工开放平台
天工开放平台,作为一家综合性技术平台,致力于提供多样化的服务和产品,以促进技术的创新和应用的发展。该平台涵盖了天工AI搜索、天工3.0大模型、搜索引擎服务,AI写作、AI陪伴以及AI音乐产品等多个领域,充分展示了其在人工智能行业的深远影响。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴