OpenDataArena
 1.63w
 0
 0
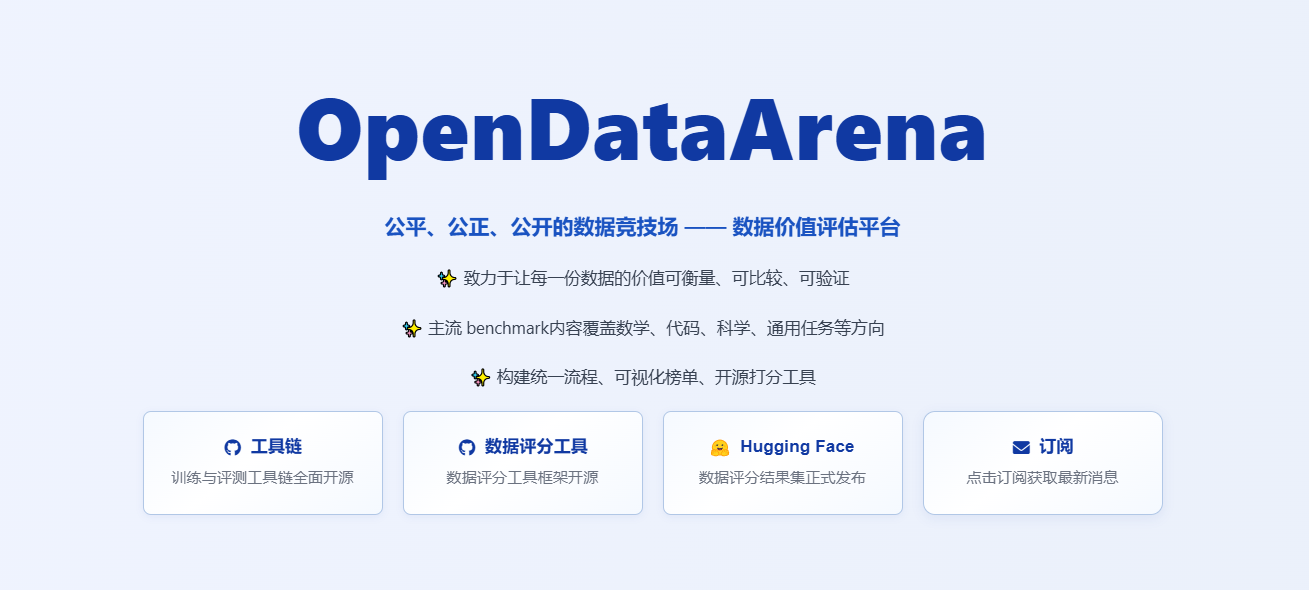
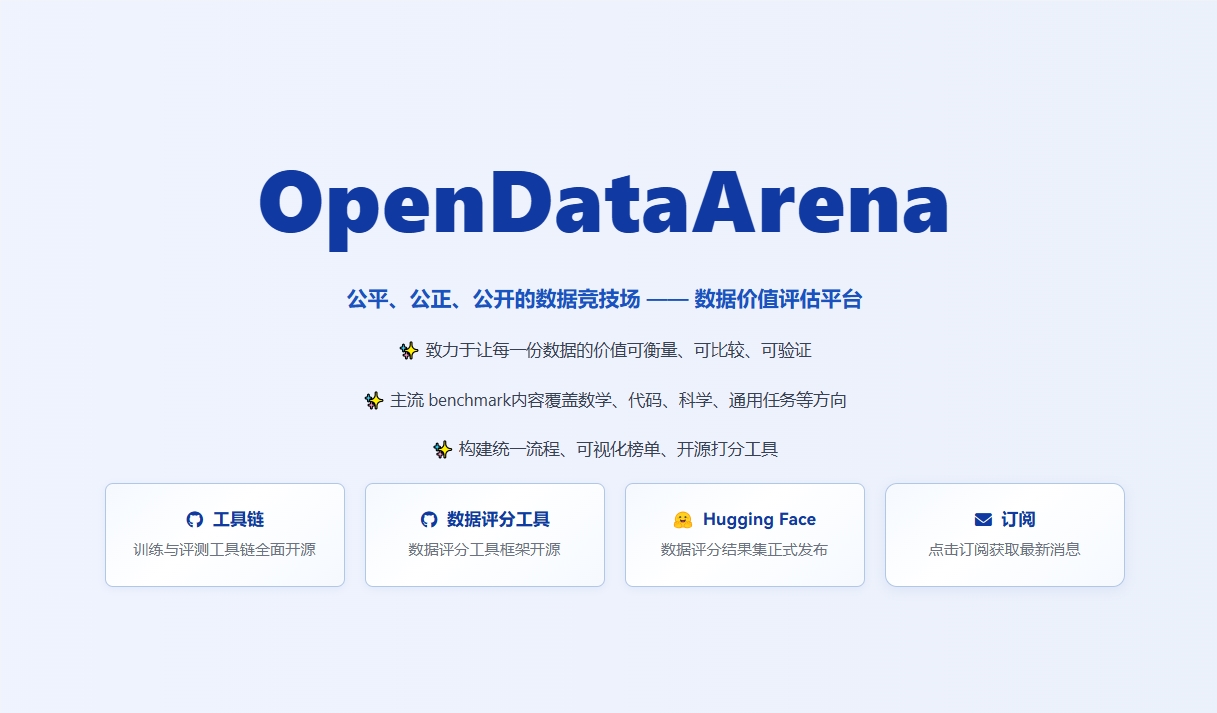
OpenDataArena (ODA)是一个开放、透明、可扩展的评估训练后数据集价值的平台,被称为全球首个开发数据竞技场,旨在使每个数据集都可测量、可比较、可验证。其核心目标是通过标准化训练与评测机制,量化不同数据集对模型性能的影响,从而解决“哪些数据真正有用”的难题。
直达网站
一、OpenDataArena是什么?
OpenDataArena (ODA)是一个开放、透明、可扩展的评估训练后数据集价值的平台,被称为全球首个开发数据竞技场,旨在使每个数据集都可测量、可比较、可验证。其核心目标是通过标准化训练与评测机制,量化不同数据集对模型性能的影响,从而解决“哪些数据真正有用”的难题。
平台涵盖四大核心功能:
- 多领域数据竞技榜单:覆盖通用、数学、代码、科学等4+领域,提供可视化排名,直观展示数据集在特定任务中的表现。
- 多维度数据打分体系:从准确性、复杂度、响应长度等20+维度对数据集及单条数据进行精细化评分,目前已开源15M+标注数据。
- 训评一体化工具链:开源基于LLaMA-Factory训练框架与OpenCompass评测框架的工具集,支持端到端复现实验流程。
- 动态更新的数据生态:每月更新数据集与评测基准,确保评估结果紧跟技术前沿。
截至2025年8月,平台已处理100+数据集、超20M数据样本,完成600+次模型训练与10K+次评估,成为全球AI研究者验证数据价值的重要基础设施。
二、核心功能:
1. 数据竞技榜单:
平台通过标准化流程比较数据集优劣:
- 数据集选择:覆盖HuggingFace上高下载量的通用、数学、代码等领域数据,确保代表性与时效性。
- 模型基准:采用Llama3.1和Qwen 2.5的7B版本作为评测模型,反映学术与工业界主流场景。
- 训练与评估:使用LLaMA-Factory框架与OpenCompass工具,固定训练参数与推理模板,排除外部干扰。
- 评测集覆盖:包含通用任务、长链推理等20+基准测试,全面评估单领域与跨领域数据质量。
最终生成的数据榜单以模型性能为指标,直观呈现数据集的“优秀程度”,帮助用户快速筛选高质量数据。
2. 多维度数据打分:
除模型表现外,平台通过三类方法对数据本身进行“体检”:
- 基于模型的评估(Model-based):如IFD(Instruction Following Difficulty)指标,量化数据指令的复杂度。
- 大模型作为评委(LLM-as-a-Judge):利用大模型评估数据的准确性、逻辑性等主观维度。
- 启发式方法(Heuristic):如统计回复长度、关键词频率等客观指标。
平台对每条数据生成20+维度评分,并开源部分评分结果,避免用户重复调用API,降低研究成本。例如,某代码生成任务中,研究者可通过“复杂度”与“错误率”维度快速定位高价值数据子集。
3. 开源工具链:
平台开源全套工具,包括:
- 训练评测工具:基于LLaMA-Factory与OpenCompass的端到端流程,支持复现实验配置。
- 数据打分工具:提供单维度与多维度评分脚本,支持自定义评估指标。
- 复现脚本与文档:详细说明训练参数、评测模板等细节,确保结果公平可比。
研究者可通过GitHub获取工具包,在本地部署评测环境,或直接使用平台开源的评分数据加速研究。
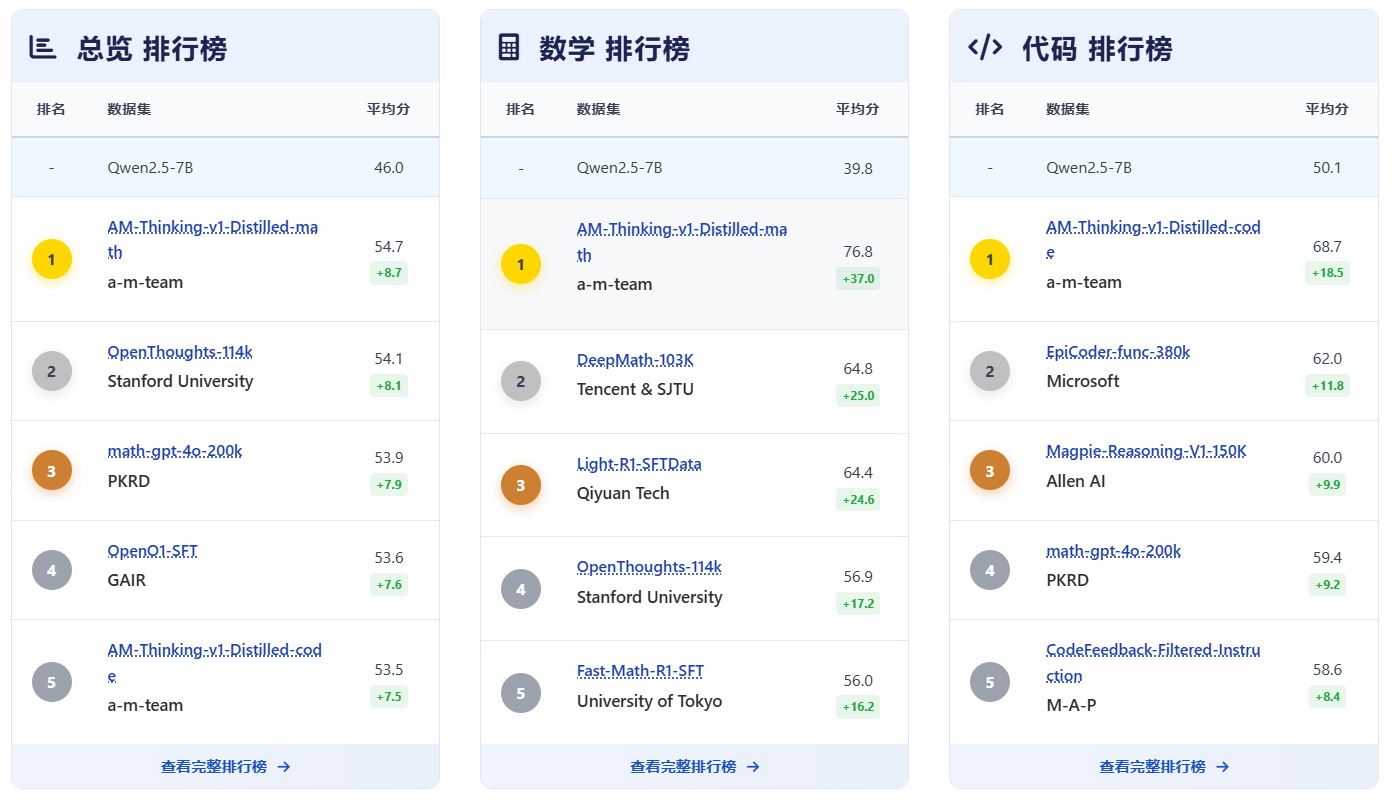
三、运作方式:
OpenDataArena的运作流程分为四步:
- 数据集选择:从HuggingFace筛选高关注度数据,按领域分类(如数学、代码)。
- 模型训练:使用LLaMA-Factory框架与固定参数训练基准模型,确保可复现性。
- 评测执行:通过OpenCompass在多维度基准测试集上评估模型性能。
- 结果分析:结合模型表现与数据打分,生成榜单与维度评分报告。
例如,在评估某数学推理数据集时,平台会:
- 训练Llama3.1 7B模型;
- 在GSM8K等数学基准上测试准确率;
- 从“逻辑严密性”“计算复杂度”等维度评分数据;
- 综合模型性能与数据评分,确定数据集排名。
四、需求人群与应用场景
1. 模型训练者与数据研究者
需求:快速筛选高质量数据集,降低试错成本。
场景:某团队训练代码生成模型时,通过平台榜单发现“CodeContests”数据集在“复杂度”与“模型准确率”维度均表现优异,将其作为核心训练数据,模型性能提升15%。
2. 数据合成研究者
需求:寻找高价值“种子数据”,优化合成数据质量。
场景:研究者利用平台开源的“数据复杂度”评分,筛选出复杂度高的代码数据作为种子,通过数据增强生成更优质的合成数据,提升模型泛化能力。
3. 学术研究人员
需求:探索数据特征与模型效果的关联,指导数据选择策略。
场景:某论文通过分析平台评分数据,发现“指令多样性”与模型长文本处理能力呈正相关,为数据收集策略提供理论依据。
五、如何使用OpenDataArena?
1. 访问平台与数据
- 官网:OpenDataArena官网提供平台介绍与榜单查看。
- 数据集:HuggingFace页面下载开源评分数据与原始数据集。
2. 使用开源工具
- GitHub仓库:OpenDataArena-Tool获取训练评测与数据打分工具。
- 文档教程:官方Wiki提供详细使用说明,包括工具安装、参数配置与案例演示。
3. 参与社区共建
平台鼓励用户贡献数据集、优化评测基准或扩展评分维度,通过GitHub提交Pull Request参与开发。
访问链接:
- 官网:https://opendataarena.github.io/index.html
- 工具:https://github.com/OpenDataArena/OpenDataArena-Tool
- 数据:https://huggingface.co/OpenDataArena
在AI“数据驱动”的时代,OpenDataArena正以科学的方法重新定义数据价值,为模型进化与AI创新铺就坚实基石。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区
AITOP100平台官方交流社群二维码:
评论
全部评论

暂无评论
热门推荐



相关推荐
豆蔻妇科大模型
豆蔻妇科大模型由壹生检康(杭州)生命科技有限公司研发,基于Qwen底座模型,通过针对性合成症状数据、蒸馏训练及医学专家标注思维链,依托高质量数据完成微调和强化训练。2025年7月,该模型以64.94分的成绩通过国家妇产科卫生高级职称(正高)笔试考试,成为首成为国内首个达到主任级医师水平的垂直医疗模型
F-Lite
F-Lite是一款基于扩散变换器架构的文本到图像生成模型,由Black Forest Labs开发并于2025年最高1024x1024图像,并具备开源特性,适用于正式登陆Hugging Face平台。该模型以10亿参数的轻量化设计,实现了高效、低成本的图像生成能力,支持通过自然语言提示生成高分辨率
Thera
Thera是一款基于深度学习的图片超分辨率模型。它能够通过学习低分辨率图像与高分辨率图像之间的映射关系,将模糊或低分辨率的图像转换为清晰、高分辨率的图像,简单理解就是免费提升图片清晰度。与传统的图像放大方法不同,Thera采用了更为先进的算法和模型结构,实现了更高质量的图像重建。
Bland TTS
Bland TTS是Bland AI公司推出的新一代文本转语音(Text-to-Speech)引擎,其核心突破在于将大型语言模型(LLM)与语音合成技术深度融合,实现了"一键克隆任意人声"与"多维度风格混搭"的双重创新。
Babel
Babel是阿里巴巴达摩院推出一款专为多语言处理而设计的开源大型语言模型。不仅支持全球使用人数最多的前 25 种语言,覆盖超 90% 的世界人口,它还将触角伸向了斯瓦希里语、爪哇语、缅甸语这类在开源大语言模型(LLM)领域鲜有人问津的语种。这一极具前瞻性的行动,势必将为数十亿以这些语言服务
ChatDLM
ChatDLM是Qafind Labs于2025年推出的新一代对话生成大模型,通过融合"区块扩散(Block Diffusion)"与"专家混合(MoE)"技术,该模型在保持7B参数量级的同时,实现了A100 GPU上2800 tokens/s的推理速度,较GPT-4等通用模型提升3-5倍。
Vidi
Vidi是字节跳动推出的一款全新多模态模型,它专注于视频理解与编辑领域,旨在通过融合视觉、音频和文本等多种模态信息,为用户提供精准、高效的视频处理解决方案。Vidi不仅能够处理长达一小时的超长视频,还能在时间检索和多模态协同处理方面展现出卓越的性能。
百炼
大模型服务平台百炼是阿里云精心打造的一站式大模型开发及应用构建平台。它整合了阿里云强大的云计算资源、先进的人工智能技术以及丰富的行业经验,为用户提供了从模型选择、开发、训练到应用构建、部署的全流程服务。无论是经验丰富的开发者,还是对技术不太熟悉的业务人员,都能在百炼平台上轻松开展大模型相关工作。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴