
Gemma
 7504
 1
 1
Gemma是谷歌最新开源的多模态大模型,主打低成本高性能。该模型共有1B(10亿)、4B(40亿)、12B(120亿)和27B(270亿)四种参数规模,即便最大的27B参数模型,也只需要一张Nvidia H100显卡就能高效推理。相比同类模型,Gemma-3在达到相同效果时,算力需求降低了10倍
直达网站
一、Gemma-3介绍
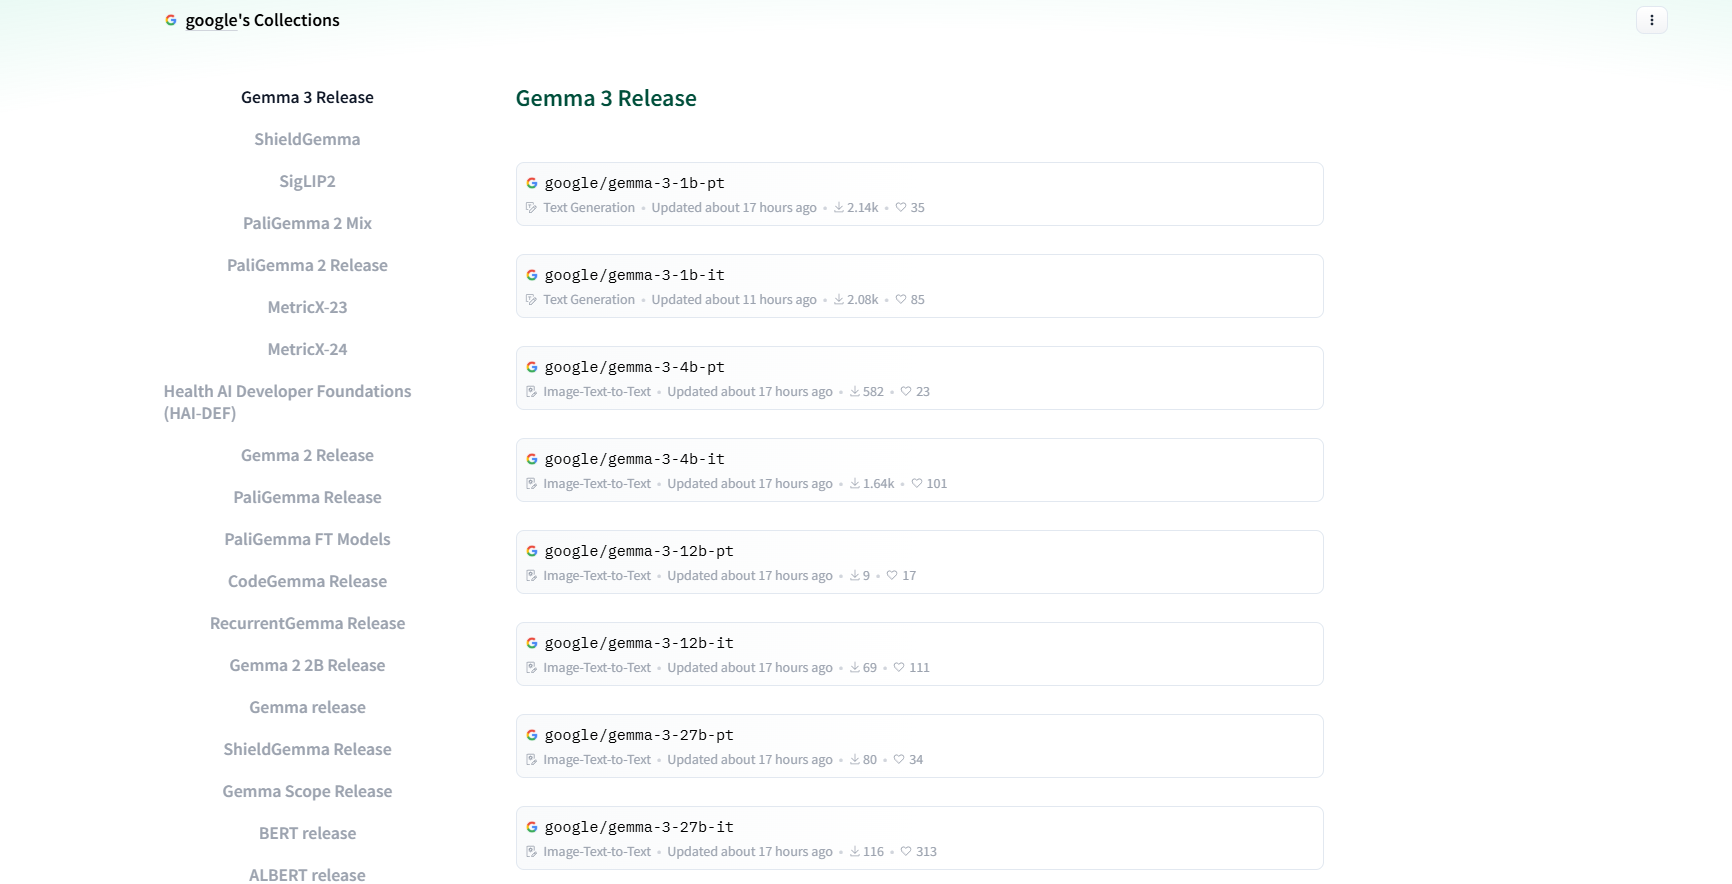
Gemma-3是谷歌最新开源的多模态大模型,主打低成本高性能。该模型共有1B(10亿)、4B(40亿)、12B(120亿)和27B(270亿)四种参数规模,即便最大的27B参数模型,也只需要一张Nvidia H100显卡就能高效推理。相比同类模型,Gemma-3在达到相同效果时,算力需求降低了10倍,是目前最强的小参数模型之一。
二、架构与技术亮点
- 通用解码器Transformer架构:Gemma-3采用了与前两代相同的通用解码器Transformer架构,但进行了众多创新和优化。
- 局部和全局自注意力层交错架构:为了应对长上下文带来的内存爆炸难题,Gemma-3采用了局部和全局自注意力层交错的架构。每5个局部层之间插入1个全局层,局部层的跨度仅为1024个token。这种设计降低了内存占用,提升了模型处理长上下文的能力。
- 扩展上下文长度:Gemma-3将上下文长度扩展到了128K token(10亿参数模型为32K),提高了模型处理复杂任务的能力。
- 提高全局自注意力层的RoPE基础频率:从10k提升到1M,而局部层频率保持在10k,使模型在长上下文场景下能够更好地捕捉信息,提升性能。
- 多模态能力:Gemma-3能够同时处理文本和图像,集成了定制版的SigLIP视觉编码器。这是一个基于VisionTransformer的编码器,通过CLIP损失的变体进行训练,提升了模型的多模态处理能力。
- 图像嵌入压缩技术:为了降低图像处理的推理成本,Gemma-3采用了创新的图像嵌入压缩技术。将视觉嵌入压缩为固定大小的256个向量,从而在不损失关键信息的前提下,显著减少了计算资源的消耗。
- Pan&Scan方法:允许模型灵活处理不同分辨率和宽高比的图像。通过将图像分割成多个固定大小的区域,并将这些区域调整到统一的分辨率后输入编码器,避免了因图像尺寸不一致而导致的信息丢失或变形问题。
三、高效训练过程
- 增加token预算:为适应图像和文本混合数据的训练需求,Gemma-3使用了比Gemma 2更大的token预算。27B参数的模型训练使用14T token,12B参数模型使用12T,4B参数模型使用4T,1B参数模型使用2T。
- 提升语言覆盖范围:增加了多语言数据,包括单语和并行数据,并借鉴特定策略处理语言表示不平衡的问题,以此提升模型的语言覆盖范围和多语言处理能力。Gemma-3支持140种语言,其中35种语言开箱即用。
- 使用SentencePiece分词器:Gemma-3使用与Gemini 2.0相同的SentencePiece分词器,具备分割数字、保留空格和字节级编码的特性。生成的词汇表包含262k个条目,使模型在处理非英语语言时更加平衡。
- 知识蒸馏技术:在训练优化上,Gemma-3运用知识蒸馏技术。每个token采样256个logits,按照教师概率进行加权,学生模型通过交叉熵损失来学习教师模型在这些样本中的分布。从而提升学生模型的性能。
- 后训练阶段:聚焦于提升模型的特定能力并整合新特性。采用了改进版的知识蒸馏技术,从大型指令微调教师模型中获取知识,同时结合基于改进版BOND、WARM和WARP的强化学习微调阶段。通过多种奖励函数来优化模型,旨在提升模型的帮助性、数学能力、编码能力、推理能力、指令遵循能力和多语言能力,同时最小化模型产生有害输出的可能性。
四、性能测试
谷歌在MGSM、Global-MMLU-Lite、WMT24++、RULER、MRCR等众多主流平台对Gemma-3进行了评估。结果显示,Gemma-3在多模态任务中表现出色,例如在DocVQA、InfoVQA和TextVQA等任务中,其性能显著优于前代模型。
在长文本处理方面,Gemma-3的27B模型在RULER128K上达到了66.0%的准确率,展现了强大的长文本处理能力。
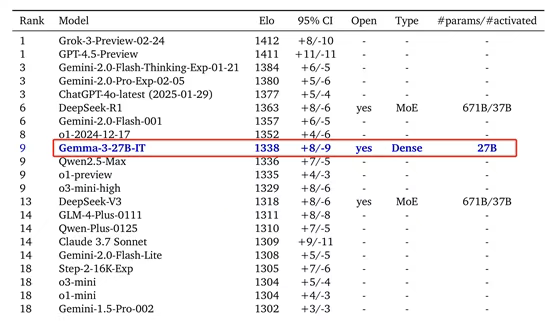
在多语言支持上,Gemma-3在MGSM和Global-MMLU-Lite等任务中也取得了优异成绩。在对话能力评估中,Gemma-3的27B指令调优版本在Chatbot Arena中的Elo分数为1338,排名进入前10,接近DeepSeek-R1等大型模型。
五、开源与应用
Gemma-3已经开源,开发者可以通过指定的开源地址获取模型和相关资源。该模型专为开发者设计,旨在支持他们构建能够在多种设备上运行的人工智能应用,无论是手机还是工作站,均可实现无缝运行。Gemma-3的推出,标志着谷歌在AI技术领域又迈出了重要一步,将进一步推动低成本、高性能AI模型的发展和应用。
概括起来,Gemma-3是一款具有强大性能和广泛应用前景的多模态大模型,值得开发者和AI爱好者关注和探索。
评论
全部评论

暂无评论
热门推荐



相关推荐
MMaDA
MMaDA是由普林斯顿大学、字节跳动、清华大学及北京大学联合研发的多模态扩散大语言模型,旨在突破传统多模态模型在架构统一性与后训练方法上的局限性。其核心目标是通过统一的扩散架构,实现文本推理、多模态理解与图像生成的跨领域卓越性能。
天工AI大模型
昆仑万维天工AI大模型是昆仑万维集团自主研发的一系列大型语言模型(LLMs),旨在通过先进的自然语言处理和深度学习技术,为用户提供高效、智能的服务和体验。该系列模型不仅具备强大的语言理解和生成能力,还广泛应用于教育、企业客服、新闻媒体、创意产业、医疗、法律咨询、金融服务等多个行业。
SpatialLM
SpatialLM是杭州群核科技自主研发的一款专为三维空间理解设计的大语言模型。它能够从普通手机或相机拍摄的视频中,快速生成物理正确的3D场景布局。这一能力使得SpatialLM在无需昂贵激光雷达或专业设备的情况下,就能实现高精度的空间数据采集与处理。
CogView4
CogView4是智谱AI推出的开源中文文生图模型。CogView4 的参数规模精准布局至 6 亿,这一参数规模,为模型构建了一个庞大且高效的 “智慧中枢”,赋予其极为强大的运算和学习能力。还全面支持中文输入和中文文本到图像的生成,被称其为“首个能在画面中生成汉字的开源模型”
AniSora
Bilibili(B站)的开源动漫视频生成模型AniSora是专为动漫视频生成设计的综合系统,该模型具备海量数据支持、时空掩码技术、专业评估体系三大核心优势,可一键生成多种动漫风格的视频内容,显著降低创作门槛并提升制作效率。
Fabric 1.0
VEED Fabric 1.0是VEED.IO 推出的全球首款AI会说话视频模型,它实现了从静态图像到动态叙事的重大跨越,仅需一张图片结合语音输入,就能生成最长1分钟、具备逼真唇形同步和自然面部表情的会话视频。该模型专为“talking head”视频设计,生成速度极快,成本大幅降低,还集成多种生态
MNN
MNN(Mobile Neural Network) 是一个专为移动端和边缘设备优化的高性能推理引擎,支持多种深度学习模型的本地化部署。其最新推出的MnnLlmApp是基于MNN框架的移动端多模态大模型应用,通过集成Qwen-2.5-Omni系列模型,首次实现了文本、图像、音频、视频的跨模态交互能力
百川大模型
百川大模型是百川智能基于先进的深度学习技术和大规模语料库训练得到的语言模型。它具备强大的自然语言处理能力和理解能力,能够生成自然、流畅、富有逻辑性的文本内容。包括闭源模型Baichuan4-Turbo、Baichuan4-Air和开源模型如Baichuan2-13B、Baichuan2-7B。
1
1
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴