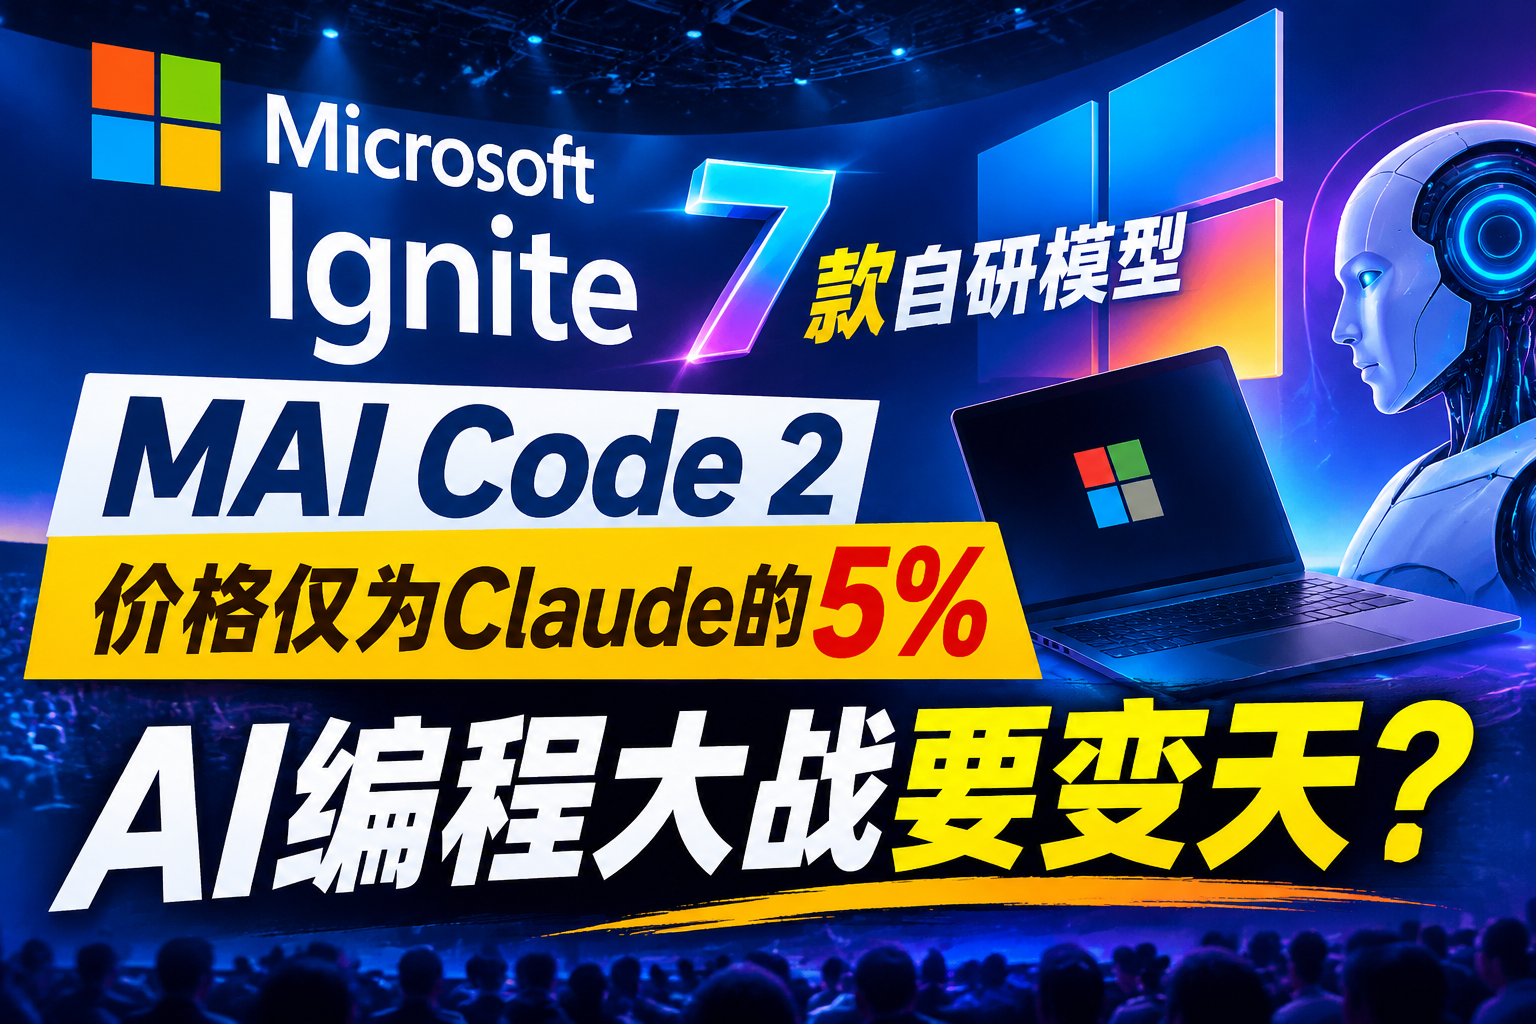
在11月17日于旧金山举行的 Ignite 2026 大会上,微软干了一件此前不敢做的事:一次性发布七款自研 AI 模型,覆盖编程、网络安全、图像生成、实时语音、语音转写与智能体决策六大方向,并把"性价比"三个字明明白白写进了发布主线。
从"依赖 OpenAI"到"自己下场"
长期以来,微软最先进的模型能力高度依赖 OpenAI。而这次发布,是微软AI负责人穆斯塔法·苏莱曼(Mustafa Suleyman)给出的明确信号:微软完全有能力开发有竞争力的自有技术,并且打算在价格上 aggressive 地竞争。
七款模型分别是:编程模型 MAI Code 2 与轻量版 MAI Code 2 Flash、网络安全模型 MAI Cyber 2 Flash、图像模型 MAI Image 2.7、实时语音模型 MAI Realtime 1、决策模型 Decision 1.1,以及基于 MAI Transcribe 2 的 Dragon Copilot Transcribe。同时,微软宣布第二代自研 AI 加速器 Maia 200 已投入生产——模型、芯片、应用三层同步推进的意图相当清晰。
MAI Code 2:把价格打到对手的零头
主角当属编程模型 MAI Code 2。微软给出的对比相当直接:在 DeepSWE 1.1、Terminal Bench 2.1、SWE-Atlas、FrontierCode v1.1 四项编程基准的平均成绩上,MAI Code 2 达到 GPT-6.1 Sol 约 98% 的质量,价格约为后者的 40%;面对 Claude Opus 5.5,达到约 96% 的表现,价格仅为后者的 5%,平均单次任务成本 0.309 美元。
轻量版 MAI Code 2 Flash 同样主打低价:性能匹配 GPT-6 Luna,价格为其 65%;匹配 Claude Haiku 5.5,成本仅为其 20%。安全模型 MAI Cyber 2 Flash 在 CyberGym-E2E 上取得 92.3%,略胜 GPT-6 Astra,单任务成本不到后者的 2%。
有意思的是苏莱曼给出的发布理由。他说自己不断听到企业客户抱怨"Token 支出正在飙升",因此微软的承诺是"提供市场上最佳的性价比,让你们真正扩展 Agent"。这句话精准击中了当下企业最痛的神经——Agent 不是跑不起,而是规模化之后账单撑不住。
当然,需要客观指出的是,这些性能与价格对比均来自微软自己的评测与定价假设,属于公司自评;微软也承认部分成本数据按促销价计算,且模型优先服务企业日常编程,尚未针对基础科学研究与超长程智能体任务调优。
GitHub Copilot 同步迎来"大更新包"
模型之外,GitHub 在 Ignite 上放出了一整套 Copilot 更新:MAI Code 2 与 Code 2 Flash 从第一天起就进入 Copilot 模型选择器和 Copilot Fusion;Fusion 还新增了 GPT-6.2 Astra/Sol 和 Claude Sonnet 5.5,构成一个多模型路由层。
更值得开发者关注的是几项工程能力:Copilot code review 新增 Adaptive effort(按 PR 自动选择审查深度)、跨仓库上下文与密钥检测;Copilot Evals 进入公开预览,可针对 skills、自定义 Agent 与 MCP 工具重跑测试;Copilot CLI 支持 Microsoft Entra 登录。这些更新的共同指向是:Copilot 正从一个"代码补全工具"进化为"可评测、可治理的 Agent 平台"。
同一天,微软董事长兼 CEO 纳德拉还宣布启动"人工智能透明度倡议",联合超过 40 家机构(包括埃森哲、Adobe、毕马威、万事达卡、沃尔沃汽车)推动跨模型、跨供应商的透明、安全与治理方法。这个倡议眼下还是合作意向,但对安全团队而言,能否真正看到模型内部的行为记录,比原则声明更有价值。
这场仗,普通开发者该怎么看?
对国内技术团队,我有三点建议:
其一,别被"5%价格"的营销话术冲昏头。促销价、自评测、特定基准,三个限定条件叠加后,真实成本需要用自己的代码库跑一遍 Copilot Evals 才能确定。其二,多模型路由正在成为标配。把底层模型绑定在单一厂商身上,风险越来越高——微软自己都在同时接入 GPT、Claude 和自研模型。其三,AI 编程的竞争焦点已经从"能不能写代码"转向"能不能验证代码"。同一天 Claude Code 团队披露其约 90% 代码由 Claude 编写和审查,并强调验证循环是扩大 Agent 并行规模的关键——不会写测试的时代,恰恰最需要会验证的人。
结语
微软用七款模型 + 一整套工具链 + 一个透明度倡议,讲了一个完整的故事:我不只要模型比对手便宜,还要让企业敢把 Agent 放进生产系统。这场仗的最终裁判不是基准分数,而是企业年底那张云账单。对开发者来说,厂商卷得越凶,我们手里的选择就越多——前提是别把鸡蛋放在一个篮子里。
(本文数据来自微软 AI 官方博客、GitHub Changelog 及主流科技媒体,性能对比为公司自评,请以实测为准。)
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说 | AI课程
AITOP100平台官方交流社群二维码: