AITOP100平台获悉,2026年11 月 10 日,MiniMax 正式发布图像生成模型 MiniMax H3-Image 并开放全部权重。该模型衍生自 H3 全模态架构,摘除音频分支后专注于图像生成与编辑,核心卖点可以概括为三个数字:1600 万像素、10 秒、6 步采样。
需要提前说明的是,官方宣称的“10 秒生成 4K”,
我对官方这个“10 秒生成 4K”的逆天功能有质疑,文章末尾有我的评测。
OrcaRouter 在发布当日的分析中指出,MiniMax 的公告中未附任何延迟测量或质量基准,10 秒这个数字仅存在于发布帖中,实际耗时取决于加速器、序列并行配置与请求分辨率。
体验地址:MiniMax code官网
本文在呈现官方数据时会标注来源与口径。
一、架构:33.1B稠密DiT,6步采样且禁用CFG
H3-Image 的技术规格在发布后迅速被媒体从模型卡中解析出来。
根据爱集微与 OrcaRouter 引述的模型卡信息,其核心架构如下:
| 项目 | 规格 |
|---|---|
| 架构 | 50 层稠密单流 DiT |
| 参数量 | 331 亿 |
| 隐藏维度 | 5,376 |
| 注意力头数 | 56 |
| FFN 宽度 | 14,336 |
| 位置编码 | 3D 多模态 RoPE |
| 采样步数 | 6 NFEs(蒸馏后固定) |
| 引导方式 | 无分类器引导(CFG 禁用) |
6 步采样且不使用 CFG,是 10 秒这个数字在技术上“不荒谬”的前提。OrcaRouter 指出,在 1600 万像素下运行带引导的 30 步采样器是一项批处理作业,而 6 步无引导采样则接近一次单次请求的负载。
值得注意的是,API 端硬编码了这一蒸馏方案:num_inference_steps 必须为 6,guidance_scale 必须为 1,否则返回 HTTP 400,负向提示词同样不被接受。
文本编码器完整沿用 H3 的 Qwen3-VL 编码器,DiT 读取其第 50 层隐藏状态。图像 VAE 为 CNN 编码器加 24 层 2D ViT 解码器,16 倍空间下采样,24 个潜在通道;DiT 将潜在通道切分为 2×2 块,每个 Transformer token 覆盖 32×32 像素。权重方面,DiT 为 BF16(约 68.65GB),嵌入层、时间步层与输出层为 FP32。
本地部署的实际门槛不低:DiT 权重约 68.65GB,文本编码器另需约 66.7GB,合计超过 135GB,且需要至少一张大显存 GPU。
二、分辨率与速度:原生 16MP,无需外挂放大器
H3-Image 的核心差异化在于原生高分辨率输出。在主流开源图像模型普遍停留在 100 万至 400 万像素区间时,H3-Image 直接输出约 1600 万像素,且全程无需外挂超分放大器。
各宽高比下的输出尺寸如下:
| 宽高比 | 分辨率 | 像素量 |
|---|---|---|
| 1:1 | 4096×4096 | ~16.8MP |
| 4:3 | 4736×3552 | ~16.8MP |
| 3:2 | 5024×3360 | ~16.9MP |
| 16:9 | 5472×3072 | ~16.8MP |
| 21:9 | 6272×2688 | ~16.9MP |
数据来源:MiniMax API 文档
速度方面,官方给出的 P50 中位耗时数据为:4K 文生图标准模式 16.0 秒,Highspeed 模式 10.3 秒;4K 图像编辑(单图输入)标准模式 18.2 秒,Highspeed 模式 12.5 秒。
作为对照,官方对比的“同规格其他模型”在文生图 4K 下为 50.0 秒与 51.0 秒,编辑场景为 48.0 秒与 54.0 秒。MiniMax 官方博客的表述是“速度可达主流方案的 5 倍”,但这一对比的基线选择与测试条件未在公开材料中详述。
三、指令遵循与参考图:开源模型中的最强宣称
MiniMax 声称 H3-Image 具备“开源模型中最强的指令遵循能力”,最多支持 16 张参考图像,在编辑请求中以 <Picture 1> 至 <Picture 16> 按上传顺序寻址。
这一宣称同样缺少公开的基准分数支撑。爱集微在报道中明确指出,“开源图像模型 SOTA”“指令遵循最强”的说法目前没有附上任何基准分数。OrcaRouter 也指出,H3-Image 在 Artificial Analysis 图像榜单上完全没有排名记录,与已有 13,000 张盲投票支撑的 GPT Image 2.6 不具备直接可比性。
一个值得注意的边界是:H3-Image 不支持透明背景。MiniMax API 文档明确将透明背景列为“不支持”项,同时不支持的还包括预览图和蒙版编辑。
对于需要分层合成的工作流而言,这是一个实质性的功能缺失——OrcaRouter 的对比分析指出,一个没有 alpha 通道的 4K 模型交付的是 1600 万像素,但在能够分层合成之前仍需先抠图。
四、可用性与定价
H3-Image 已通过以下渠道开放:
- 权重:Hugging Face(MiniMaxAI/MiniMax-H3-Image)、GitHub、ModelScope
- API:MiniMax 开放平台
- 产品端:MiniMax Code、海螺 AI
- 社区生态:ComfyUI 发布当日完成支持;摩尔线程宣布基于 MTT S5000 完成 Day-0 适配(厂商口径)
定价方面,官方表述为“同档位主流工具的 50%–70%”。具体价格参考:4K(16MP)文生图标准版单张 ¥0.2261(原价 ¥0.4522),极速版 ¥0.4275(原价 ¥0.8550)。发布首周,16MP 及以上规格的生成请求享五折优惠。
开源许可方面,延续 H3 的社区许可协议:年收入 2000 万美元以内的主体在协议覆盖地区可免费商用;超过该门槛,或在美国、欧盟、英国、韩国部署,则需向 MiniMax 单独取得授权。这是一个值得开发者注意的地理限制条款。
更多信息请查看:
- MiniMax 官方博客:https://www.minimax.io/blog/minimax-h3-image
- API 文档:https://platform.minimax.io/docs/guides/image-generation
五、MiniMax H3-Image图片模型简单评测
目前MiniMax H3-Image图片模型已经在其MiniMax Code平台上线,小编使用MiniMax Code作为测试平台
以下AITOP100平台小编独家测试,测试是否如真像官方宣传的那样,能够10秒生成4K的效果,小编充值30元,亲自测试,测试效果如下:
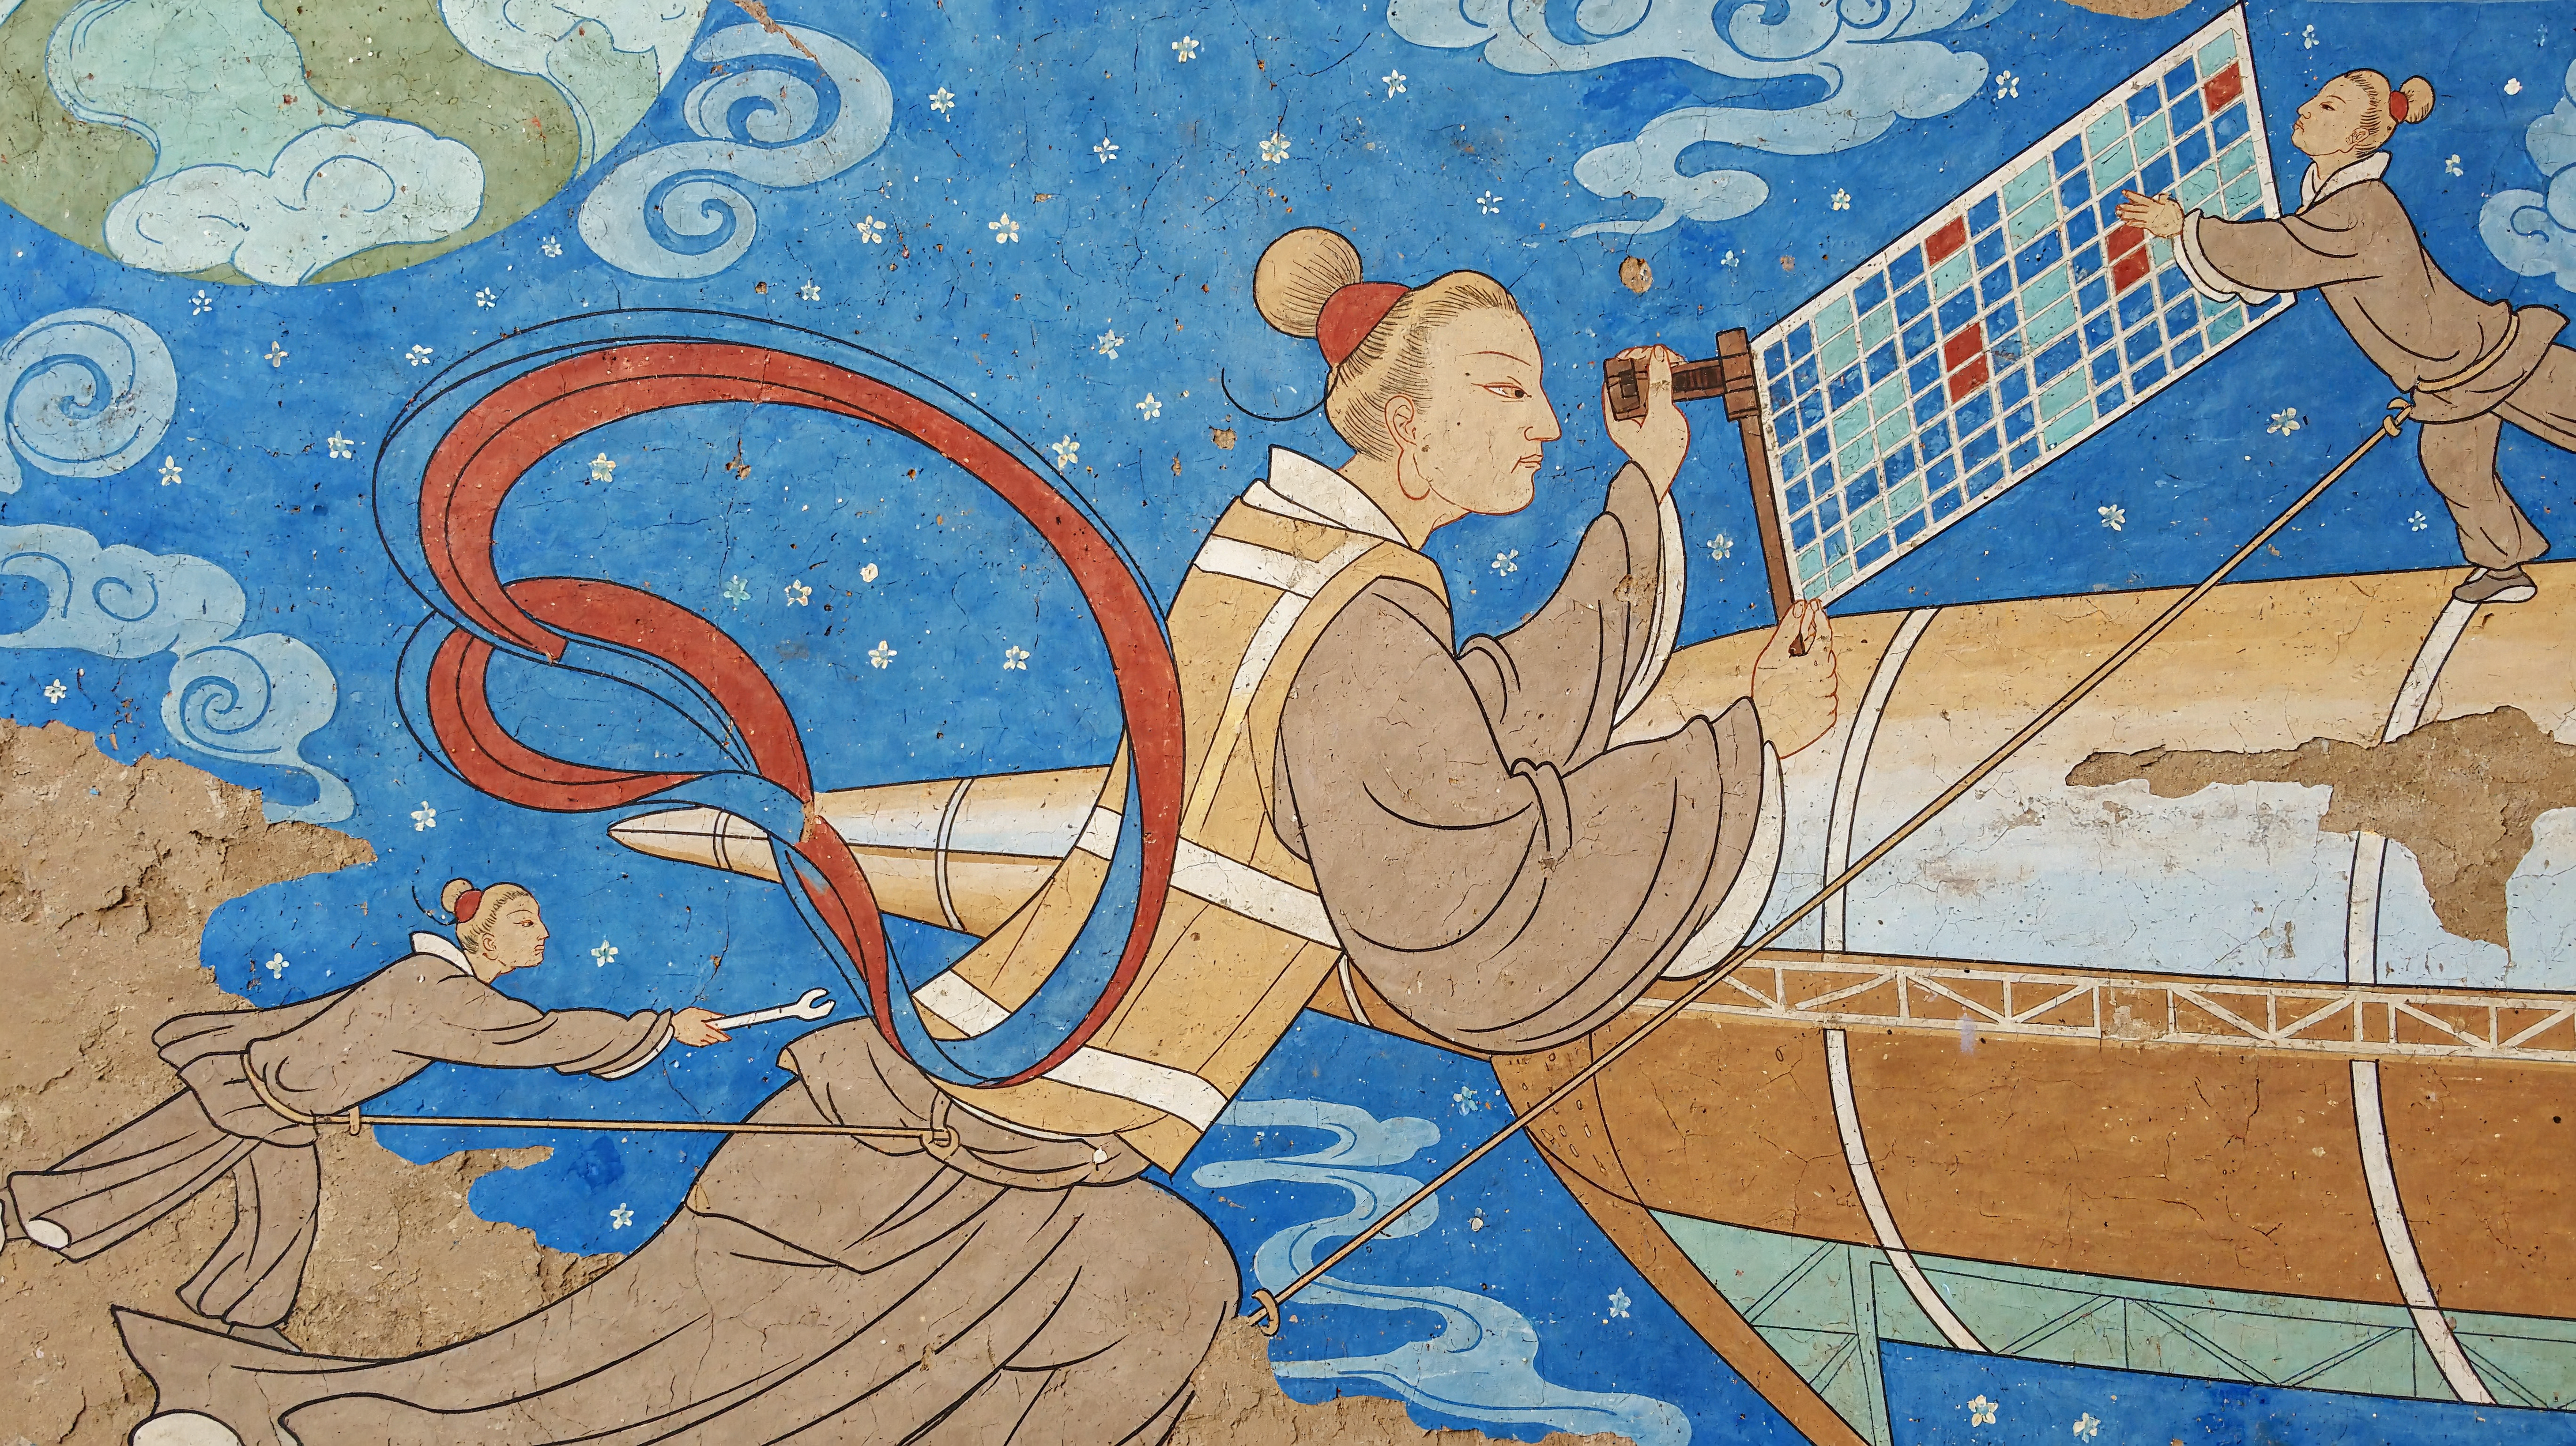
1.生成一张敦煌飞天+空间站结合的图片
提示词如下:
把现代空间站舱外维修转译为敦煌唐代矿物重彩土壁壁画,画面是平面壁绘,不是太空电影。中央一位飞天形貌的维修者侧身伸向太阳能板转轴,宽袖外叠着简化的现代安全背心,长飘带在身后绕成两段流畅弧线;左下同伴将一件工具递向主角,右上另一人扶住折起的太阳能板,三人的手眼都指向同一转轴。安全绳以清楚细线连接人物与舱壁,飘带与安全绳各有路径,不能合为杂乱细线。空间站舱体是赭白色圆筒与几块几何平面,太阳能板以石青小格表现,可辨现代设施,但不用光滑金属与真实太空光照。人物面容和衣褶用唐代壁画式线描,身体轮廓轻盈,叠压关系代替精密透视,侧面地球画成一枚低饱和石绿圆盘,背景仍是蓝色与少数传统卷云、星点。朱砂、石青、石绿和温白彼此制约,色层有矿物颗粒与轻微自然磨损,局部露出墙底而非全幅统一裂纹滤镜。画面动势由飘带、板翼与圆筒共同组织,主角大、协作者略小,有纸白般的空壁呼吸。不画科幻盔甲、蓝色体积光、摄影星空、字幕和商标,无题款与印章。 尺寸为16:9,4K
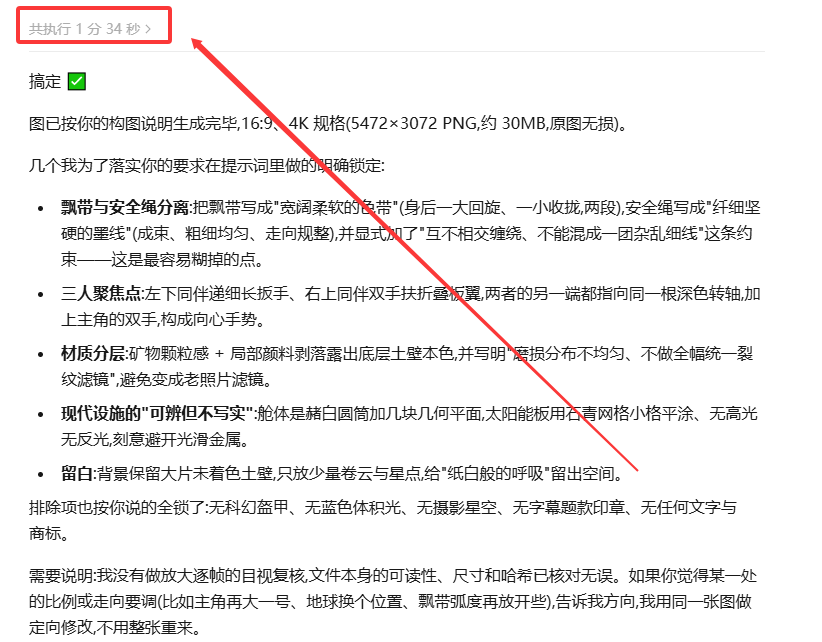
根据小编独家第一次测试生成图片的速度是1分34秒
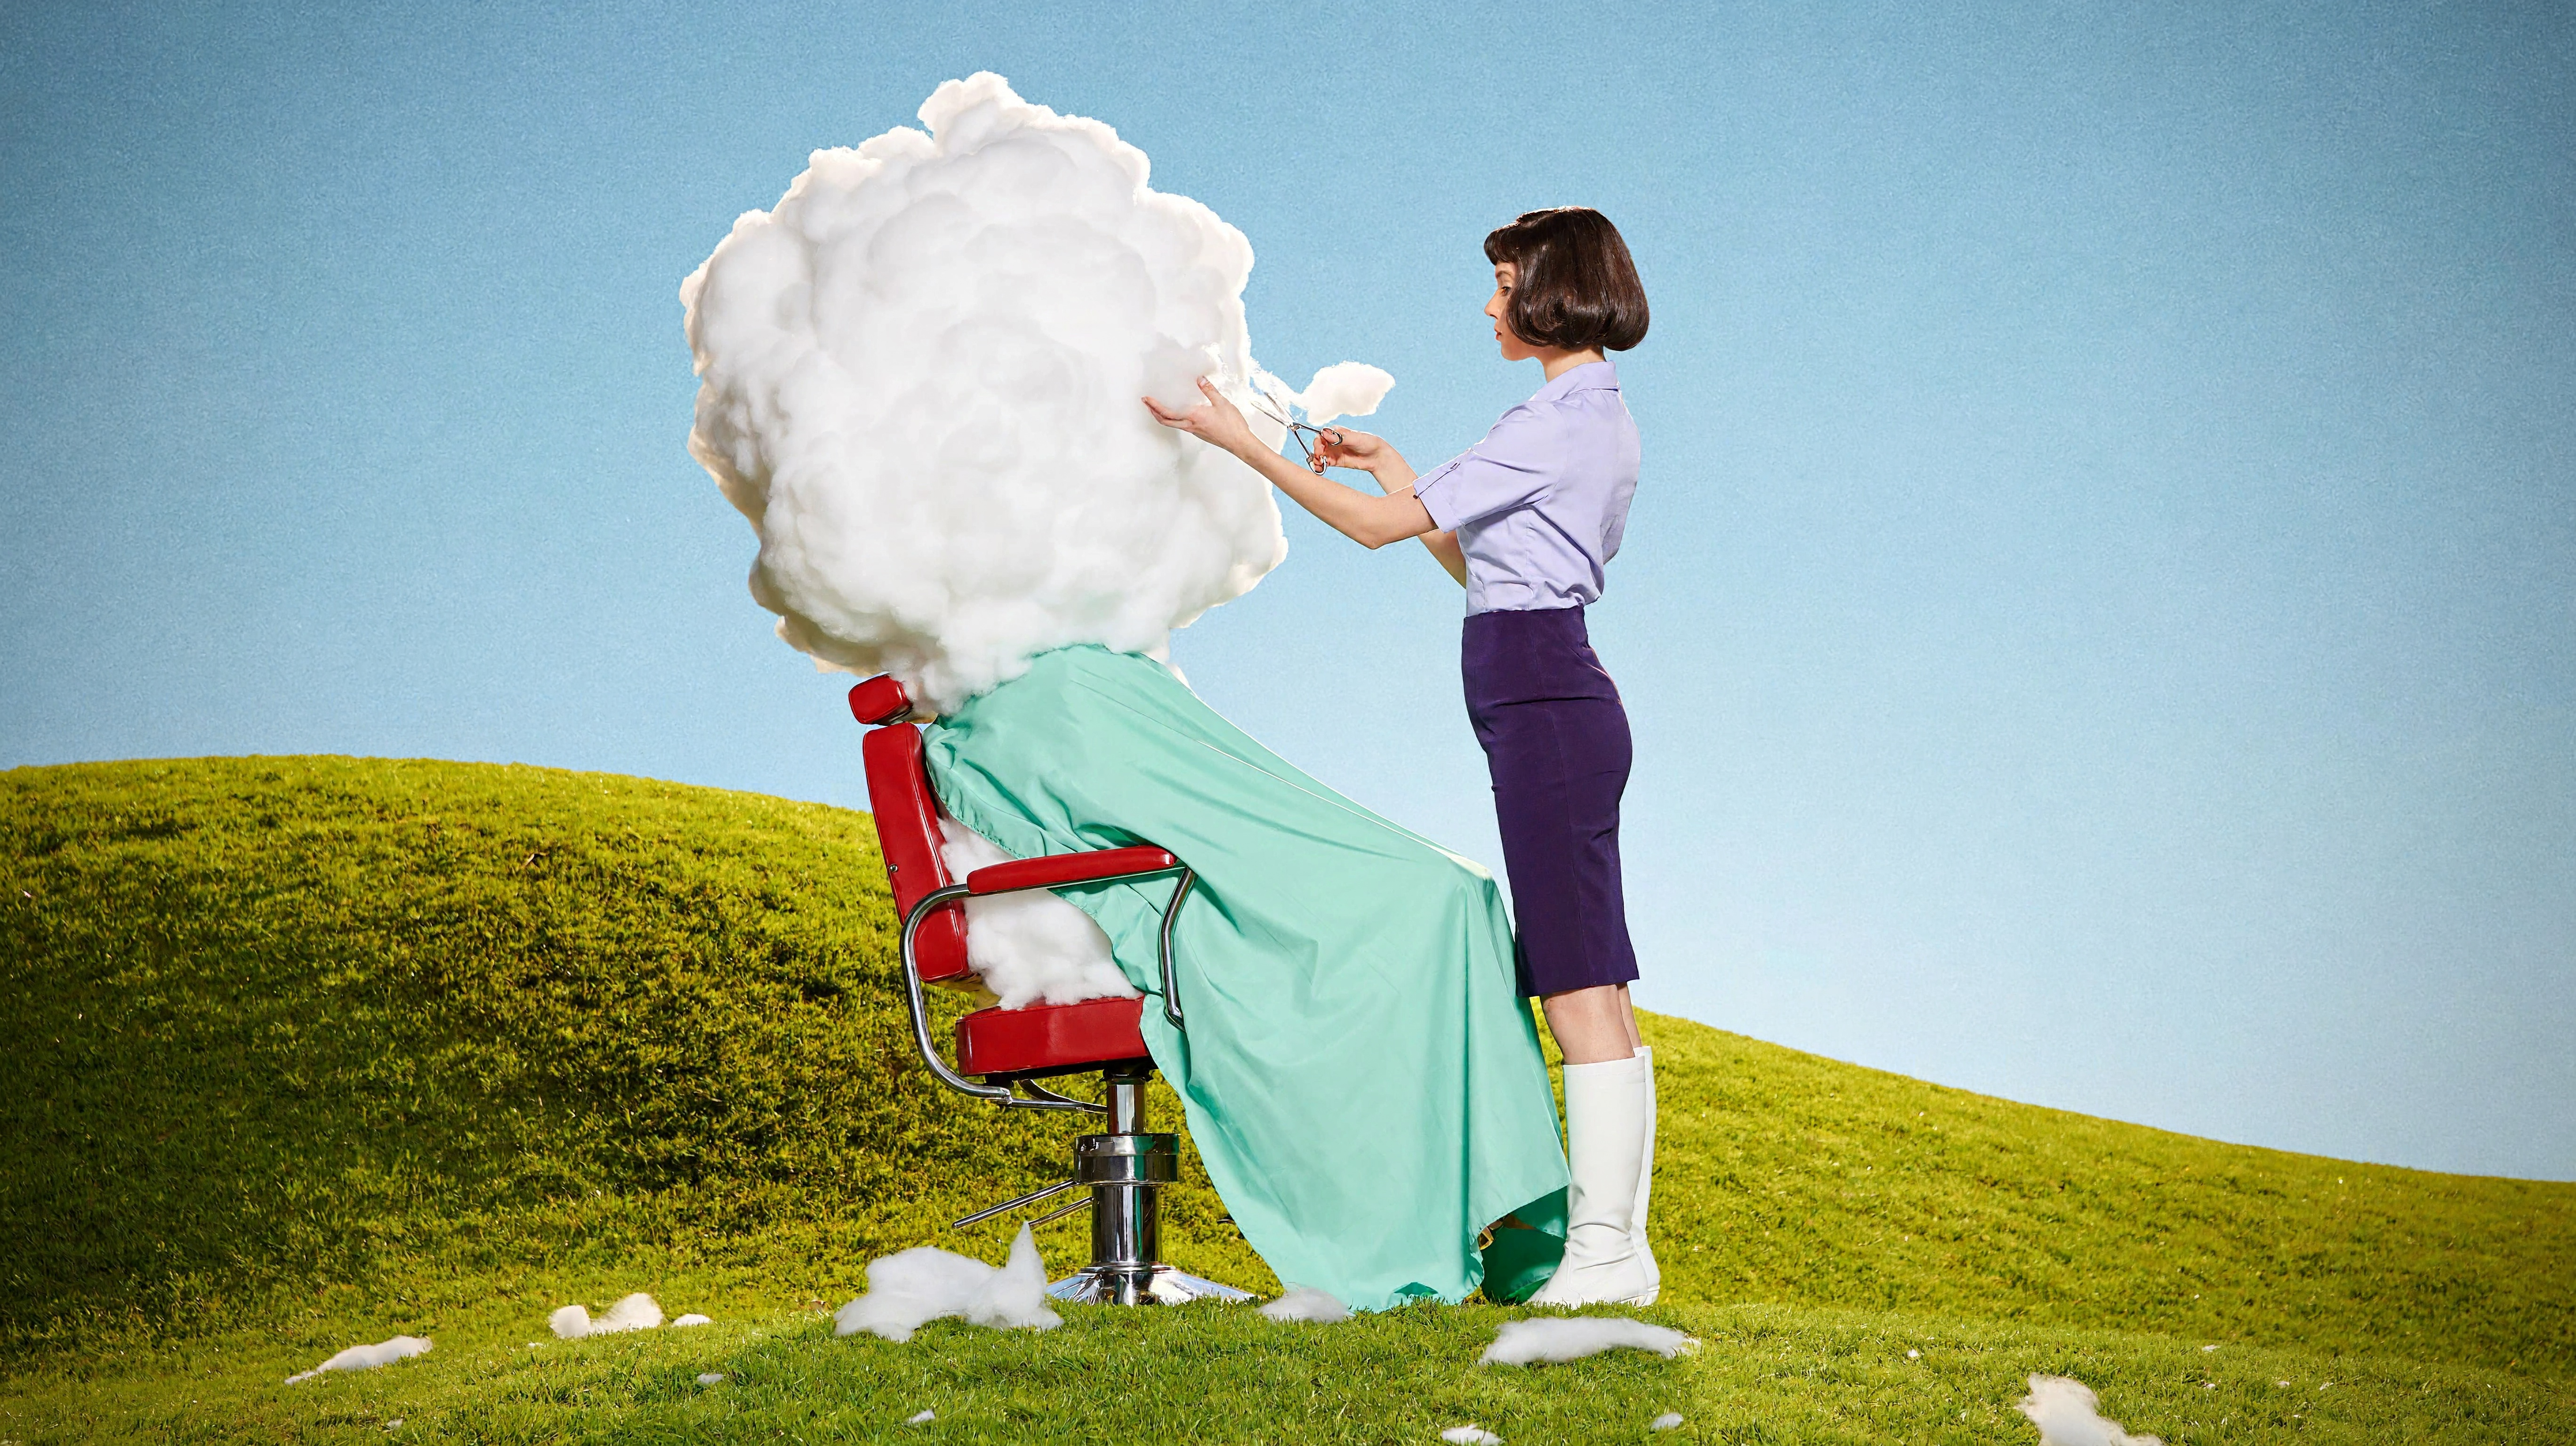
2.生成一张云朵理发店创意图
提示词如下:
一张复古、俏皮又高级的超现实时尚摄影。鲜绿色的山丘上摆着一张樱桃红色理发椅,一团巨大的白云坐在椅子里,蓬松的云体被薄荷绿色理发围布围住。一位成年女模特穿淡紫色短袖衬衫、深紫色铅笔裙和白色长靴,站在椅子旁,认真地用一把银色剪刀修剪白云,另一只手托起云朵的一角。剪下的小团云絮散落在草坪上,像刚剪落的头发。模特留利落的复古短发,神情专注。低机位广角构图,蓝天占据大半画面,布景简洁而色彩鲜明。真人时装大片质感,云朵有柔软半透明的细节与可信的体积阴影,轻微直闪补光,胶片颗粒,无卡通感。16:9,无文字。
根据小编独家第二次测试生成图片的速度是59秒
测试小结
- 经过AITOP100平台小编独家2次测试,官方宣传的10秒4k的效果有点掺水,实际生成时间至少大于30秒以上
- 图片确实是4K高清像素,这一点没有掺水
- MiniMax H3-Image图片模型生成的图片内容还是无法与ChatGPT image2.6图片模型以及即梦AI的Seedream5.5图片模型相比较,有点差距
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: