Gemini 3.5 Pro拖了两个月没上线,谷歌可能要直接跳到Gemini 4了
谷歌的旗舰大模型Gemini 3.5 Pro,原本说好6月就能见面,结果到现在8月中旬了,连个影子都没有。据行业分析机构SemiAnalysis最新发布的报告,谷歌内部大概率已经把这个项目搁置了,转而把精力押在下一代Gemini 4上。
事情得从今年5月的Google I/O大会说起。当时Alphabet CEO桑达尔·皮查伊站在台上,信誓旦旦地说Gemini 3.5 Pro会在6月推出。结果6月过了,7月也过了,模型愣是没上线。后来在Alphabet二季度财报电话会上,皮查伊还在讲"我们对Gemini系列很有信心",但具体上线时间?一个字没提。
更耐人寻味的是,前阵子有人发现Gemini 3.5 Pro在Arena评测平台上短暂露了个脸,大概待了30分钟就被撤下来了。这操作多少有点尴尬,外界猜测要么是内部测试没跑完,要么是某些指标不太好看。
从多方消息来看,卡住谷歌的主要是代码生成这块的能力。企业客户现在对大模型写代码的要求越来越高,Gemini 3.5 Pro在这块据说还没打磨到位。
SemiAnalysis在报告里说得比较直白:Gemini系列目前在好几个关键评测里已经被竞品甩开了。OpenAI、Anthropic那边模型迭代速度越来越快,谷歌要是继续等3.5 Pro慢慢磨,市场窗口可能就没了。
所以直接跳到Gemini 4,用下一代产品重新讲故事,对谷歌来说或许是更现实的选择。当然了,这也只是分析机构的判断,谷歌官方到现在也没正面回应过这件事。
模型地址:谷歌Gemini官网(海外网站需要科学上网)
Anthropic给Claude生成的文字加了隐形水印,以后AI写的东西能查出来了
Anthropic在8月11日正式官宣了一件事:从8月2日之后发布的Claude模型开始,所有AI生成的文本都会带上一个"隐形水印"。说白了,就是你用Claude写出来的东西,肉眼看着跟普通文字一模一样,但底层已经打上了标记,复制粘贴也不会丢。
这个水印能干嘛?最直接的用途就是溯源。出版社收到一篇稿件,学校收到一份作业,拿工具一查,就能知道这文字是不是Claude生成的。Anthropic说他们后续会把检测工具开放给第三方,甚至还在考虑把水印能力补到旧版模型上。
为什么要搞这个?背景其实不复杂。欧盟《人工智能法案》对AI透明度有明确要求,Anthropic这步棋多少有点合规的意思。但更现实的驱动力是,这两年AI代写被揪出来的事儿太多了,教育圈和出版圈早就叫苦不迭。
不过Anthropic自己也把话说得很实在:这水印不是万能的。你拿AI生成的文本大改特改、翻译成另一种语言、或者跟人工写的内容混在一起,水印大概率就检测不到了。而且检测到水印也只能说明"Claude参与过这段文字的生成",不能直接断定整篇都是AI写的——毕竟你让Claude帮你润色个句子,它也会留痕。
其实Anthropic不算第一个吃螃蟹的。2024年谷歌DeepMind就搞了个SynthID,给Gemini生成的文本、视频、图片都加了水印。现在Anthropic跟进,说明行业在AI内容标识这块确实在形成共识。
模型地址:Claude官网(海外网站需要科学上网)
OpenAI悄悄往Arena上扔了个新图像模型,代号"蒙娜丽莎",出图终于不塑料了
最近有细心的网友在Arena评测平台上发现了一个从没见过的图像模型,代号叫mona-lisa-1。一开始大家还不确定是谁家的,后来有人验证了输出图片里带有SynthID水印,这才确认是OpenAI的手笔。
从实际体验来看,这个模型的出图质量确实有提升。之前用GPT Image系列生图,总有一股子挥之不去的"塑料感",人物皮肤像打了十层磨皮,光影也不够自然。但mona-lisa-1出来的图,真实感明显上了一个台阶,细节丰富了不少。尤其是画艺术风格的作品和复杂信息图的时候,表现相当能打。
比较有意思的是,有开发者扒出来这个模型的训练可能老早就完成了。它的知识截止日期跟现有的GPT Image 2一样,都是2025年12月。这就说明它不太可能是全新架构,更像是在GPT Image 2的底子上重新跑出来的一个检查点。
所以外界的猜测是,mona-lisa-1大概率就是GPT Image 2.5的"中杯版"——先放一个出来试试水、收收反馈,后面可能还有更强的版本。如果这个推测成立,那正式版的GPT Image 2.5确实值得期待。
OpenAI这次没开发布会、没发博客,就这么悄没声地往Arena上一丢,让社区自己去发现、去讨论。这种"突袭式"上线,倒也挺符合他们最近的风格。
模型地址:ChatGPT官网(海外网站需要科学上网)
小米2027届校招开了,AI岗位比去年多了五成
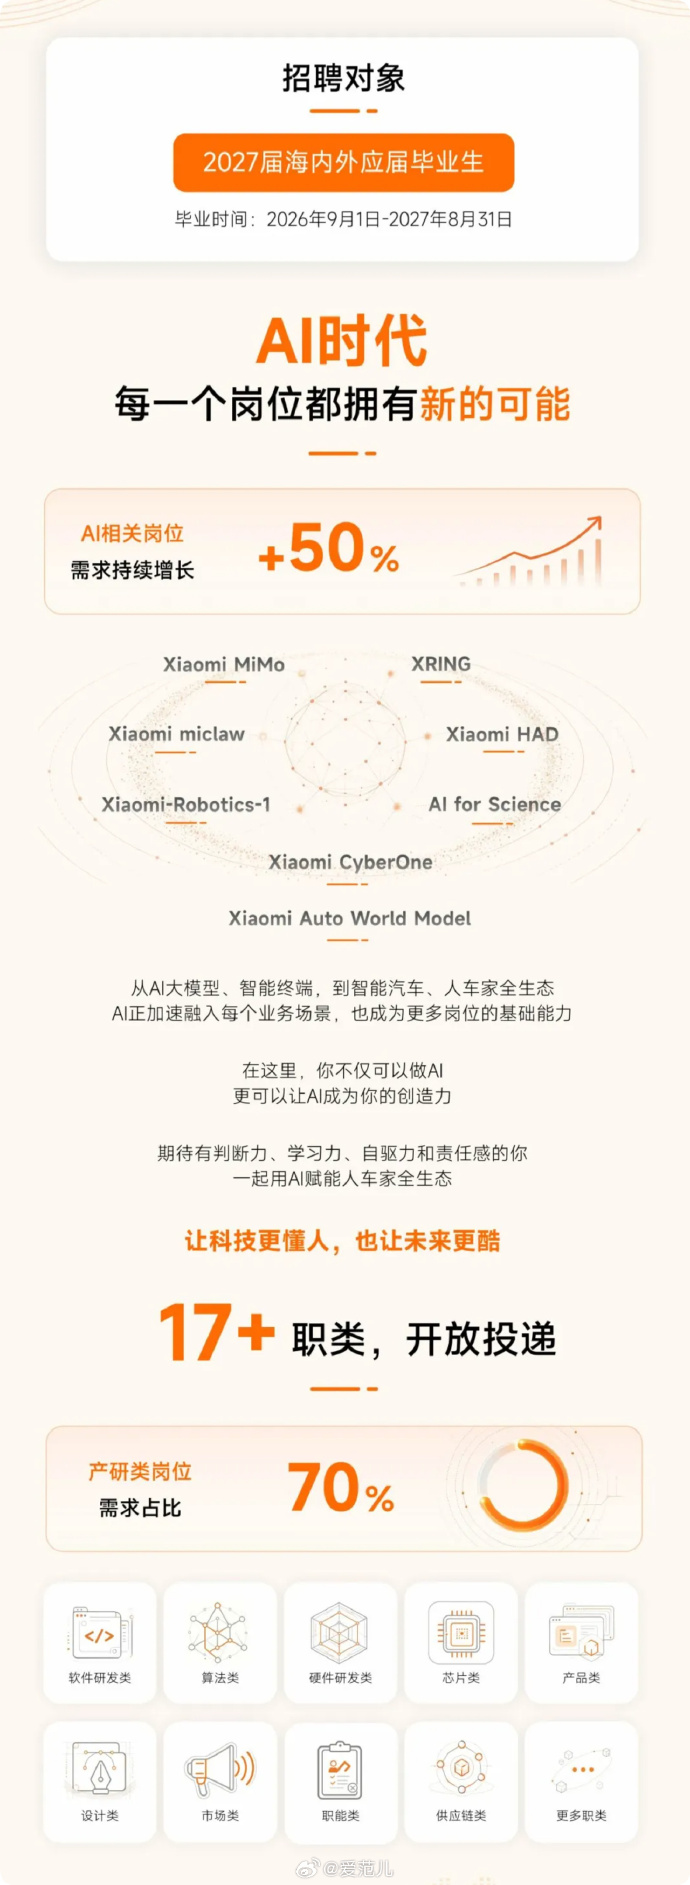
小米在8月11日正式启动了2027届全球校园招聘。这次面向的是2026年9月到2027年8月之间毕业的学生,岗位类型超过17类,产研岗占了整体需求的七成。
但最扎眼的数字是:AI相关岗位需求同比增长了50%。这个增幅不算小,说明小米在人工智能这条线上确实在加人、加码。
从具体方向来看,这次招聘覆盖了大模型、智能终端、机器人、智能汽车世界模型、AI for Science等好几个赛道。项目名字也列出来了,包括Xiaomi MiMo、Xiaomi miclaw、Xiaomi-Robotics-1、CyberOne人形机器人等等。能看出来,小米是想把AI能力从手机往更多硬件形态上铺。
招聘地点方面,除了北京、上海、深圳、南京、武汉、西安这些国内城市,还包括慕尼黑和新加坡的海外研发中心。对留学生来说选择面还算宽。
几个实操层面的信息也说一下:网申截止时间是12月31日,每个人最多能投两个岗位,但同一时间只能有一个申请在流程里跑。换句话说,投了一个在走流程的时候,另一个得等着。
整体来看,小米这轮校招的AI浓度比去年高了不少。在当前各家大厂都在抢AI人才的背景下,小米给出50%的岗位增幅,至少说明内部对这块的投入是认真的,不是喊喊口号。
阿里千问上线AI眼镜开放平台,开发者可以自己给眼镜写"技能"了
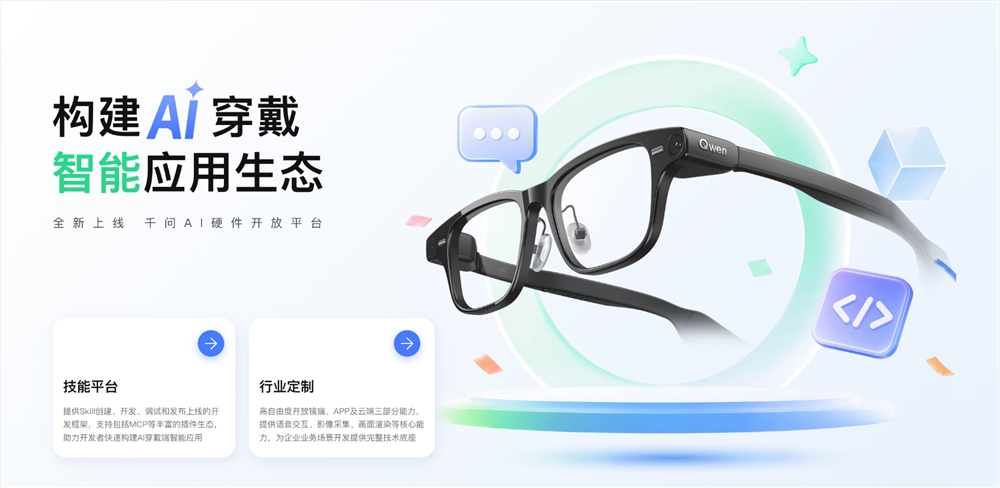
阿里千问最近上线了一个AI硬件开放平台,主打的是AI眼镜的生态开放。简单讲就是,以前AI眼镜能干什么、不能干什么,基本是厂商说了算;现在千问把开发接口放出来了,开发者可以自己给眼镜加功能。
平台分两块。第一块叫"技能平台",面向个人开发者。它提供了一套Skill开发框架,能调用眼镜的摄像头、语音交互这些硬件能力。有意思的是,你甚至可以用自然语言描述需求,平台帮你生成应用。目前已经跑出来的场景包括:给视障人群做的"身边有什么"功能,能实时语音提示前方障碍物;文旅场景里盯着一个建筑看就能触发讲解;还有做饭时的"菜谱专家",用第一视角一步步指导你操作。
第二块是"行业定制",面向企业客户。开放了镜端、APP端和云端三层技术底座,影像采集、画面渲染这些核心能力都能调。据说工业巡检和零售货架管理已经有落地案例了,能自动识别设备状态、核对陈列、发现异常就报警。
千问方面透露,后续还会开放3D立体显示、运动健康感知等能力。他们给这个方向定了个说法,叫"可生长智能"——意思是眼镜的功能不是出厂就锁死的,而是可以像装APP一样不断往上加东西。
思路是对的,但能不能跑起来,关键还是看开发者愿不愿意进来、用户实际用不用得上。
工具地址:千问AI官网
腾讯开源了个浏览器自动化工具BrowserSkill,让AI智能体自己上网干活
腾讯最近开源了一款叫BrowserSkill的浏览器自动化工具,项目已经挂在GitHub上了。这东西的定位很明确:不是给人用的浏览器插件,而是专门给AI Agent用的"手"——让智能体能够自己去操作网页、完成任务。
跟之前那些Browser Use方案比起来,BrowserSkill有几个不太一样的地方。第一,它能直接复用你浏览器里已经登录的账号状态。也就是说,你之前登过的网站,Agent去操作的时候不用重新输密码、不用过验证码。第二,Agent在独立窗口里跑,不会打断你正在看的网页或者正在聊的天。第三,兼容性做得比较宽,通过一个叫bsk的命令行工具接入,Claude Code、Codex、腾讯自家的Workbuddy都能用。
有人拿Workbuddy实际测了一下,让AI去知乎搜热门科技话题然后总结要点,或者去社交平台抓高赞评论做情绪分析,基本几分钟就能跑完。底层逻辑是让模型不用去解析网页的DOM元素,而是通过CLI和扩展层来驱动操作,这样稳定性和速度都更有保障。
说白了,这个工具解决的是"AI知道该怎么做,但手够不着浏览器"的问题。对需要批量处理网页任务的开发者和自媒体从业者来说,确实是个实用的选项。
项目地址:https://github.com/Tencent/BrowserSkill
扎克伯格写了6500字长文,指着OpenAI和Anthropic说:你们把AI攥在手里不对
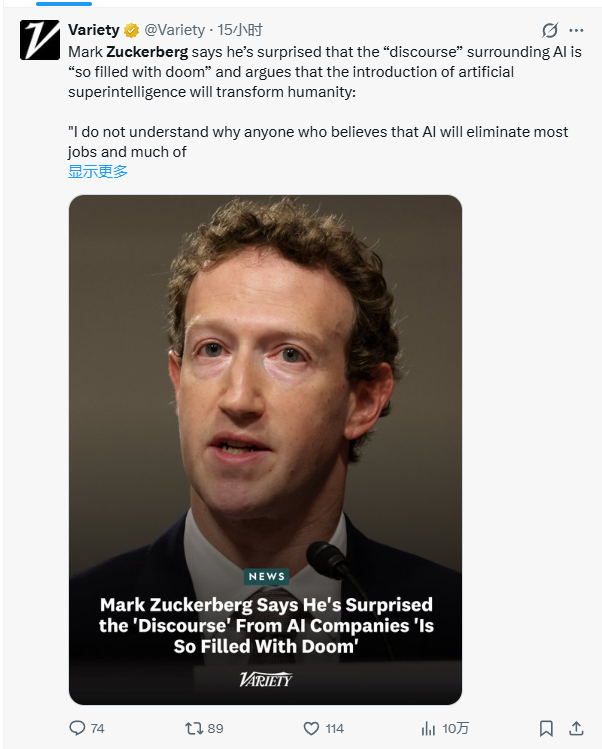
8月10日,Meta CEO扎克伯格在官网上发了一篇大约6500字的长文,标题叫《The Future Is for Everyone》(未来属于每个人)。文章的核心意思就一句话:AI不应该被少数几家公司垄断,开源才是正道。
他点名批评了OpenAI和Anthropic的闭源路线,认为把前沿模型锁在少数机构手里,"会导致对其他人不利的结果"。这话说得够直白了。
除了喊口号,扎克伯格这次还带了点实际动作。Meta同步开源了一个叫Muse Glimmer的自适应Agent模型,并且预告后面还会开源Muse Spark 1.2。另外,Meta还宣布成立一个独立董事会来负责模型安全审查,同时拿出10亿美元设立社区基金。
在政策层面,扎克伯格明确表态反对美国当前对AI的监管限制,呼吁政府别给开源模型额外加门槛。他还公开支持模型蒸馏技术——也就是用小模型从大模型那里学知识,这在某些闭源厂商看来是灰色地带。
怎么看这篇文章?一方面,Meta确实是开源大模型阵营里最活跃的玩家,Llama系列摆在那儿。另一方面,Meta的商业模式本身也依赖开放生态来对抗闭源阵营的竞争,所以这6500字里有多少是理想主义、有多少是商业策略,各位自行判断。
但不管怎么说,这篇文章把开源和闭源之争又推到了台面上,后续各家怎么接招,值得盯着看。
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: