2026年9月22日,云栖大会在杭州正式拉开帷幕。作为AI行业一年一度的风向标盛会,本届大会释放的信号尤为清晰——大模型正在从“可用”加速迈向“更强、更智能、更普惠”。阿里巴巴在会上公布了千问大模型(Qwen)的一系列最新进展,其中最引人瞩目的,莫过于Qwen4系列模型已正式投入训练,未来版本参数规模将扩展至5万亿至10万亿(5-10T)量级。
与此同时,大模型递归自我改进(RSI)技术已在训练、推理及芯片协同等环节取得实质性突破,多模态模型矩阵也迎来全面升级。
模型地址:通义千问官网
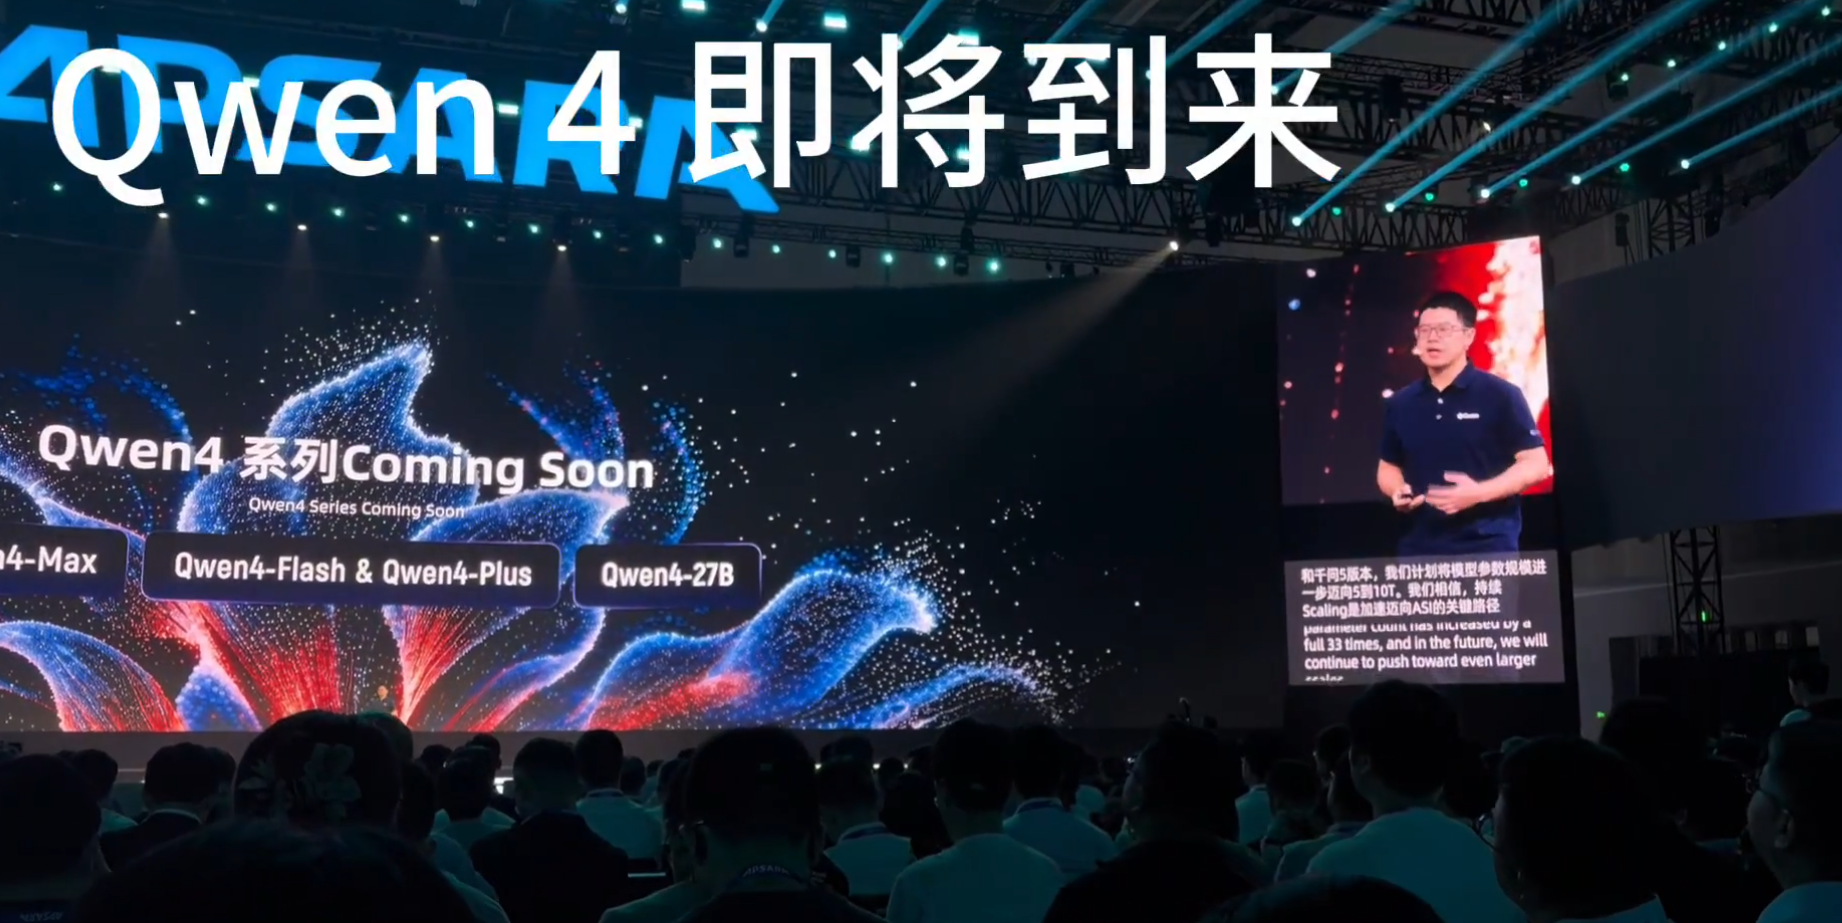
Qwen4:下一代架构已启动训练
根据大会披露的信息,基于下一代架构的Qwen4已全面投入训练阶段。值得注意的是,阿里并未在会上正式发布Qwen4的具体型号,而是明确透露了后续版本的演进路线:Qwen4.5、Qwen5等版本将把参数规模扩展至5万亿到10万亿。
这一规划背后,是阿里对Scaling Law(缩放定律)的持续信仰。Qwen LLM项目负责人刘大一恒在演讲中明确表示,Scaling是迈向超级人工智能(ASI)的关键路径。从Qwen3系列到Qwen4,再到未来5-10T的宏伟目标,阿里正在以“更高智能”为核心驱动力,加速推进大模型的能力边界。
需要说明的是,在Qwen4正式发布之前,阿里已于2026年8月开源了基于Qwen4架构的技术预览版模型Qwen3.8-Flash-Next(线上生产版本命名为Qwen3.8-Flash),作为完整Qwen4模型家族推出的先导预览。该模型采用MoE(混合专家)架构,总参数125B、激活参数6B,原生支持262K上下文并可扩展至1M Token,已在代码编写、智能体任务等专业场景展现出显著增强的能力。
RSI:大模型开始“自我进化”
如果说Qwen4的参数量级代表了“规模”的突破,那么递归自我改进(RSI)技术的进展则标志着大模型正在获得“自我进化”的能力。
大会披露,Qwen3.8-Max已能在人类完全“零参与”的情况下,自主搭建训练流程、构造训练数据、自主设计实验并定位缺陷,持续迭代超过1个月,完成33轮有效迭代。基于RSI与后训练等系列技术联合优化,Qwen3.8-Max新版本在Artificial Analysis上的得分从40分提升至45分,与Claude、GPT的最强模型同处全球第一阵营,领先于GLM5.3、Kimi-K3等所有国产模型。
RSI的探索还在向上下游延展:
- 推理优化:Qwen3.8-Max在从未见过的平头哥新款GPU上,自主适配优化了Qwen3.8-Flash新模型的推理框架,实现单实例推理吞吐量提升96%。
- 芯片协同设计:Qwen3.8-Max仅基于一份真实的总线模块规范,自主展开前端、验证、后端的全链路自迭代,在自主运行超60小时、调用EDA工具超万次后,完成了减少42%面积的物理实现优化,标准单元数降低29%,功耗降低59.5%。
这一系列突破意味着,大模型不再仅仅是被“训练”出来的工具,而是开始具备自主优化、自主适配的能力。这不仅是技术层面的跃升,更可能从根本上改变大模型的研发范式。
Qwen3.8系列:当前最强阵容盘点
在Qwen4到来之前,Qwen3.8系列仍是阿里大模型的“当家主力”。本届云栖大会上,Qwen3.8系列的多款模型也集中展示了其强劲实力:
- Qwen3.8-Max:在编程(Coding)和办公(Cowork)领域表现突出,发布后斩获Artificial Analysis Agentic智能体第一、CodeArena前端编程第一。
- Qwen3.8-Flash:通过架构创新开启缓存命中输入低至每百万Tokens 0.1元的全新时代,训练成本降低近90%,推理效率达到行业领先水平。
- Qwen3.8-27B:这款270亿参数的稠密(Dense)模型于2026年8月14日开源,支持262K原生上下文(可扩展至1M Tokens),在编程和办公场景的性能甚至超越了Qwen3.7-Plus。开源后迅速登顶Hugging Face全球大模型趋势榜,被社区誉为“本地Opus 4.6”,4bit量化后约17GB显存即可运行,让消费级显卡用户也能体验旗舰级能力。
- Qwen3.8-Omni:全模态模型,将视频、音频、图片和文字纳入统一理解框架,标志着大模型进入多模态统一理解阶段。
截至目前,阿里已累计开源460余个Qwen系列模型,全球下载量突破30亿次,衍生模型超30万个,稳居Hugging Face开源社区榜首。Qwen已成为全球AI开源社区的基座模型,包括DeepSeek、英伟达、AWS、微软等知名公司都基于Qwen二次开发出相关衍生模型。
多模态矩阵全面升级:从语言到“全模态”
除了大语言模型,阿里在多模态领域的布局同样令人瞩目。本届大会上,视频、语音、图像、音乐、世界模型等多个赛道均迎来新版本发布:
- 视频生成:Wan3.0已在Artificial Analysis文生视频与视频编辑双榜位列全球第一,支持单次30秒视频生成、原生音画同步。全新的下一代视频生成模型将于2026年11月发布,朝着“更长、更可控、更完整、更智能”的方向演进,具备导演级的叙事理解能力。
- 语音模型:Qwen-Audio-3.1系列在ASR(语音转写)、TTS(语音合成)、Realtime(实时交互)三个核心赛道均位列国际第一梯队、国内第一,超越Gemini 3.1 TTS等国际顶尖模型。
- 图像生成:Qwen-Image-3.1面向电商设计场景优化,将视觉创作周期从数小时压缩至秒级;Qwen-Image-2.1全面开源,原生支持透明图生成。
- 音乐模型:Happy Shrimp 1.1新增百余种曲风与十余种语言支持,覆盖人声与纯音乐场景。
- 世界模型:HappyOyster 2.0 Preview通过架构革新,显著提升物理规律模拟与实时交互能力,推动世界模型从实验室走向真实可用。
- 同声传译:Qwen3.8-LiveTranslate将翻译时延压缩至2.5秒内,低于人类同传平均水平,已接入AI眼镜、桌面机器人等硬件设备。
阿里巴巴ATH技术副总裁郑波在大会现场预测,三年内将出现原生全模态统一模型,彻底打破模态交互边界。
终端落地:AI走向“人手一个”
大模型的终极价值在于落地应用。本届云栖大会上,阿里发布了AI手机全栈解决方案Qwen Intelligence,通过深度优化跨应用任务执行能力,为合作伙伴提供可靠的Agent技术平台。目前,Qwen系列模型已覆盖手机、AI眼镜、桌面机器人等多类智能终端,形成从云端到端侧的完整技术布局。
与此同时,平头哥发布了新一代训推一体AI芯片真武V900,单芯片性能是真武M890的3倍,搭载216GB显存,计划于2027年第一季度量产。吴泳铭在主题演讲中表示,到2032年,阿里云运营的全球数据中心规模将超过20GW。模型、芯片、云三大基础设施的协同发力,正在为AI的规模化供给奠定坚实基础。
从Qwen3.8系列的全面开花,到Qwen4的蓄势待发,再到5-10T参数规模的宏伟蓝图,阿里正在用持续的技术迭代证明:大模型的竞争远未结束,真正的“大时代”才刚刚开始。
Qwen4全家桶即将到来,我们非常期待!
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: