📰 事件脉络与关键争议点
| 维度 | 说明 |
|---|---|
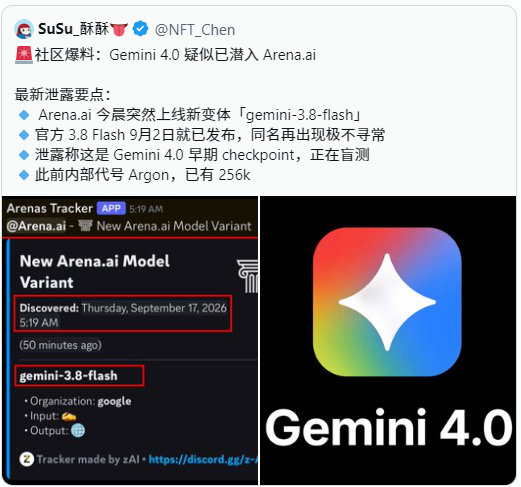
| 传言起点 | 9月17日 X 用户 @NFT_Chen 称 Arena 盲测中“Gemini 3.8 Flash”选项表现异常聪明,生成耗时显著增加,并贴出疑似内部 checkpoint 编号 G4P-INT-ARGON-SEPT11-B02 |
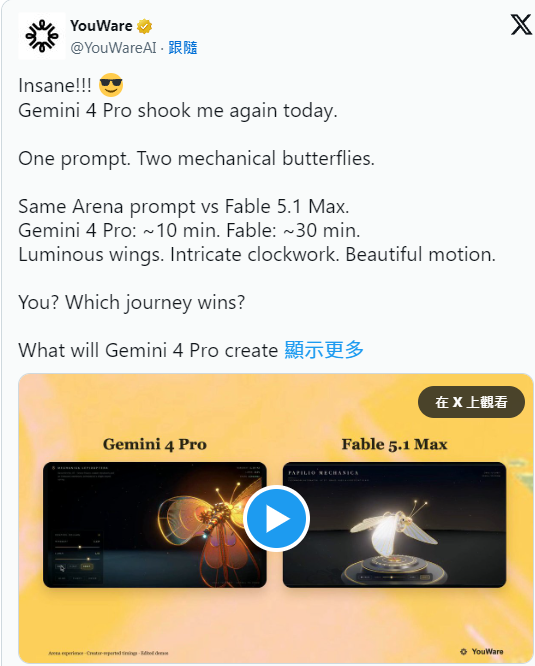
| 扩散节点 | 同日 @LuminaBench 等账号声称验证同一 checkpoint;AI 应用平台 YouWare 官方账号发布多支“Gemini 4 vs GPT-6/Fable 5”对比影片,形容前者“表现惊艳”,但所有贴文均导流至自家平台 |
| 证据弱点 | 所谓“内部探测”结果多为直接询问模型身份所得自述,语言模型对自身识别本就不可靠,易产生幻觉;YouWare 未说明取得测试权限之来源,且具明显商业导流动机 |
| 官方立场 | Google 仅于7月21日及7月下旬财报会确认“已启动迄今最具野心的预训练”用于 Gemini 4,未提及发布日期、定价、型号或基准测试;Arena 排行榜亦无 Gemini 4 踪影 |
| 当前结论 | “Gemini 4 已在 Arena 测试”尚无可验证证据支撑;那个特别聪明的“3.8 Flash”真实身份,唯有 Google 能给出答案 |
🔍 深度解读:为何此类传言容易引发信赖危机?
此次风波暴露了 AI 社群在信息验证上的三大结构性脆弱点:
- 模型自述≠鉴识证据语言模型被问及“你是谁”时,其回答本质上是基于训练数据的概率预测,而非系统级身份认证。将此类输出当作“内部代号泄露”,等同于把幻觉当证物。真正的模型版本识别应来自 API metadata、推理基础设施日志或官方签署的 checkpoint hash,而非对话内容。
- 第三方导流与信息纯度的冲突YouWare 作为 AI 应用建构平台,其发布对比影片的动机天然带有产品推广属性。即便影片内容真实,其选择性呈现(仅展示有利片段)、缺乏测试环境透明化(未公开 prompt、参数、推理端点),以及强制导流行为,都严重削弱了内容的中立性与可重复验证性。
- 官方沉默加剧猜测空间Google 对 Gemini 4 采取极度保守的沟通策略,仅确认“正在训练”,其余一概不谈。这种信息真空虽出于竞争考量,却为未经证实的传言提供了滋生温床。当用户无法从权威渠道获得锚点,便只能依赖碎片化线索自行拼凑叙事——而这类叙事往往更戏剧化、更易传播,也更难纠错。
⚠️ 风险提醒与务实建议
- 对开发者 :切勿依据未经证实的模型传言调整技术路线或产品排程。若需评估新模型能力,应等待官方 API 上线后通过标准化基准测试验证,而非依赖社群影片或盲测轶事。
- 对内容创作者 :引用此类传言时务必标注“未经证实”,并明确区分“模型自述”与“系统级证据”。避免将第三方导流内容包装成客观评测。
- 对一般用户 :保持对“惊人表现”叙事的审慎态度。AI 模型迭代确实在加速,但重大突破通常伴随官方公告与可重复验证的基准数据,而非仅存于社交平台短片之中。
结语在 AI 竞赛白热化的当下,“幽灵测试”传言或许反映了社群对下一代模型的殷切期待,但期待不应取代验证。在 Google 正式揭晓之前,所有关于 Gemini 4 的细节,终究只是回荡在信息迷雾中的回声。