
Marble
 1.84w
 0
 0
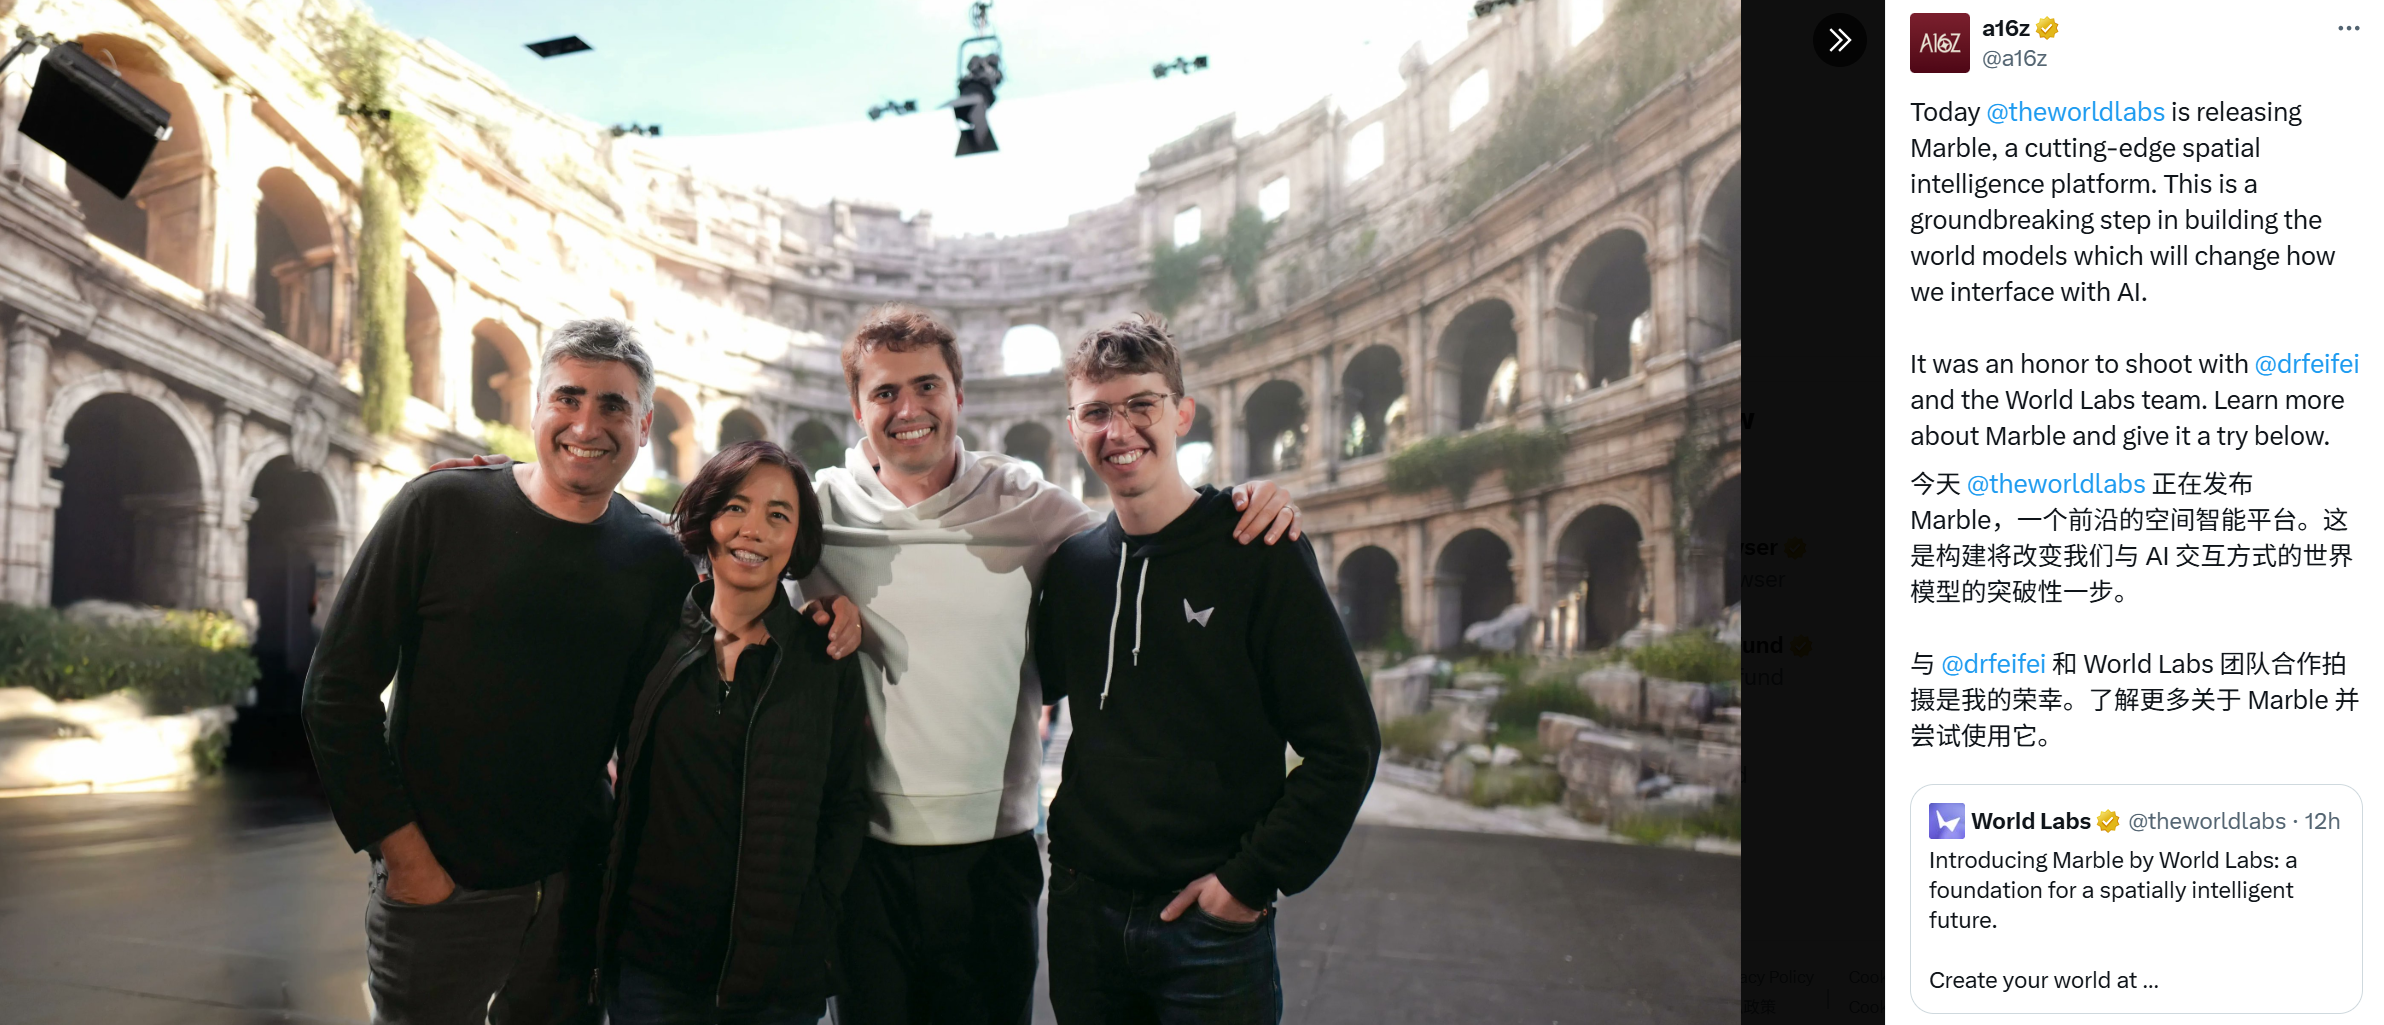
Marble是由斯坦福大学教授、"AI教母"李飞飞创立的World Labs推出的全球首款商用多模态世界模型。作为生成式AI领域的革命性产品,Marble突破了传统3D建模的技术边界,通过文本、图像、视频甚至3D草图等多种输入方式,可实时生成具备物理规则的持久性3D环境。
直达网站

一、Marble是什么?
Marble是由斯坦福大学教授、"AI教母"李飞飞创立的World Labs推出的全球首款商用多模态世界模型。作为生成式AI领域的革命性产品,Marble突破了传统3D建模的技术边界,通过文本、图像、视频甚至3D草图等多种输入方式,可实时生成具备物理规则的持久性3D环境。其核心价值在于将单维度的内容生成升级为可交互的立体空间构建,为VR、游戏、影视等行业提供标准化3D资产生产解决方案。
二、主要功能:
多模态内容生成
- 文本生成场景:输入"中世纪城堡与龙"等描述,自动生成包含细节纹理的3D世界
- 图像/视频转3D:单张照片可扩展为360度全景空间,短视频能还原真实场景的数字孪生
- 3D布局创作:通过结构草图与风格提示词分离设计,实现建筑与艺术风格的自由组合
智能空间编辑系统
- Chisel雕刻工具:支持3D空间直接拖拽建模,结合文本提示调整光影材质
- 区域扩展功能:可选择特定区域进行细节增强,解决传统建模中的模糊死角问题
- 世界组合模式:将多个独立场景无缝拼接,构建超大规模虚拟世界
产业级导出支持
- 兼容高斯泼溅(Gaussian Splats)、网格模型(Mesh)等工业标准格式
- 与Blender、Unreal Engine、Unity等主流引擎无缝对接
- 支持视频导出与动态增强,可添加光影特效和物理模拟
三、核心优势:
- 空间一致性区别于市面常见的"瞬时生成"模型,Marble构建的3D环境具备物理规则约束,确保视角转换时空间结构稳定不变。例如在游戏场景中,远处的建筑细节不会因镜头移动而扭曲。
- 编辑自由度提供从宏观布局到微观材质的多层级编辑能力。开发者可先通过文本生成基础场景,再用3D工具精细调整建筑结构,最后通过风格迁移统一视觉语言。
- 产业适配性输出的3D资产可直接用于影视渲染(如OTOY Octane 2026渲染器)、游戏开发(Rosebud AI已落地多人恐怖游戏)、空间计算(Apple Vision Pro原生支持)等商业场景。
四、需求人群:
- 3D内容开发者游戏设计师可快速生成可玩性地图,影视特效师能直接导出影视级场景资产,建筑师通过空间模拟验证设计方案。
- AI科研机构为机器人训练提供逼真的虚拟环境,助力医学领域构建人体器官3D模型,支持科学实验的数字孪生模拟。
- 跨领域创作者广告从业者制作沉浸式品牌空间,教育机构开发交互式学习场景,艺术创作者探索虚实融合的新媒体表达。
五、应用场景:
- 元宇宙基建为Meta、Roblox等平台提供标准化3D场景库,降低UGC内容创作门槛。某团队利用Marble 72小时搭建出可探索的古罗马城邦。
- 影视工业化《阿凡达3》制作团队采用Marble生成潘多拉星球的生态场景,渲染效率提升40%,且支持导演实时修改环境参数。
- 智能制造西门子工业软件集成Marble API,在数字工厂中模拟产线布局优化方案,缩短3D建模周期60%。
- 空间计算革命Apple Vision Pro开发者通过Marble生成支持空间音频的交互场景,用户可在虚拟画廊中自然行走观赏艺术品。
六、产品愿景:
Marble的终极目标不仅是3D内容生成工具,更是构建空间智能的基础设施。李飞飞教授提出:"当AI理解物体在三维空间中的真实交互,将引发科学、医学、机器人等领域的范式革命。"
- 短期(1-3年):完善多智能体交互功能,支持VR用户实时修改场景参数
- 中期(3-5年):建立空间知识图谱,实现物理规则的自动模拟(如流体动力学)
- 长期(5-10年):开发通用空间智能,使AI具备在虚拟与现实世界中自主解决问题的能力
七、行业影响:
据麦肯锡研究,Marble类工具将在2030年前创造超过200亿美元的市场价值,推动影视、游戏、建筑等行业进入"所想即所得"的创作时代。正如Unity CEO所言:"这不仅是技术突破,更是人类与数字世界交互方式的根本变革。"
Marble的出现标志着AI从理解语言到重构空间的跨越,其开放的Marble Labs创意社区已吸引超过10万名开发者,每天产生数百个创新应用案例。当3D建模不再需要专业软件操作,当虚拟场景的生成如编辑文档般简单,一个全民创作立体数字内容的新时代正在到来。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区
AITOP100平台官方交流社群二维码:
评论
全部评论

暂无评论
热门推荐



相关推荐

VACE
阿里通义Wan团队推出的视频生成和编辑模型VACE,是一款集多功能于一体的创新工具,它支持按条件生成视频、精确控制物体运动轨迹、一键替换视频主体、风格迁移、画面扩展及静态画面动态化等,极大地提升了视频创作的效率和趣味性,为视频内容创作领域带来了全新的可能性。
小悟空AI
小悟空基于大语言模型的AI工具合集,用智慧的服务,满足用户的工作、生活和娱乐需求。该应用还具有智能对话功能,可以解决用户遇到的问题并进行辅助推荐。
AudioStory
AudioStory模型是腾讯ARC实验室推出的一款开源音频模型,该模型用大语言模型生成长音频,通过创新的“分而治之”策略与双通道解耦机制,解决了长音频生成中的逻辑与情感断层问题,实现了电影级音频的智能生成与续写,并正以开源策略推动AI音频叙事领域的技术革新。
Sonic-3
Sonic-3是美国生成式AI公司Cartesia推出的第三代实时文本转语音(Real-time TTS)模型。它基于自研的State-Space序列架构,在保持极低保真延迟最低90ms的同时,首次在公开API中实现了情绪标签驱动的笑声、呼吸、停顿与多情感强度控制,被业内称为会笑会喊的大语言模型。
Shisa.AI
Shisa.AI是一家总部位于日本东京的AI实验室,专注于为日本市场开发开源的AI语言和语音模型。公司致力于通过优化后训练流程和合成数据驱动的方法,提升AI模型在日语环境下的性能,推动日语AI应用的发展。Shisa V2405B模型,这一开源模型被誉为“日本有史以来训练的最强大型语言模型“。
Audio2Face
Audio2Face是英伟达推出的一款生成式AI面部动画模型,该模型通过深度学习和机器学习算法,实现了从音频输入到面部动画输出的实时转换。近日,英伟达宣布开源了这一模型,不仅提供了核心算法,还附带了软件开发工具包(SDK)和完整的训练框架,为游戏和3D应用领域的智能虚拟角色开发提供了强有力的支持。
Sec-Gemini v1
Sec-Gemini v1是谷歌基于其Gemini模型构建的一款全新AI安全模型。它集成了Gemini的先进推理能力,并结合了近乎实时的网络安全知识和工具,旨在帮助网络安全专业人员更有效地应对网络威胁,提升威胁情报分析、漏洞理解和事件响应的效率。
CausVid
CausVid是一种基于自回归因果推理架构的AI视频生成模型,专为解决传统模型“生成速度慢、长视频质量差”的痛点而设计。由麻省理工学院计算机科学人工智能实验室(CSAIL)与 Adobe Research 联合研发,这一混合模型可以在几秒钟内生成高质量视频。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴