F-Lite
 1.47w
 0
 0
F-Lite是一款基于扩散变换器架构的文本到图像生成模型,由Black Forest Labs开发并于2025年最高1024x1024图像,并具备开源特性,适用于正式登陆Hugging Face平台。该模型以10亿参数的轻量化设计,实现了高效、低成本的图像生成能力,支持通过自然语言提示生成高分辨率
直达网站
F-Lite是什么
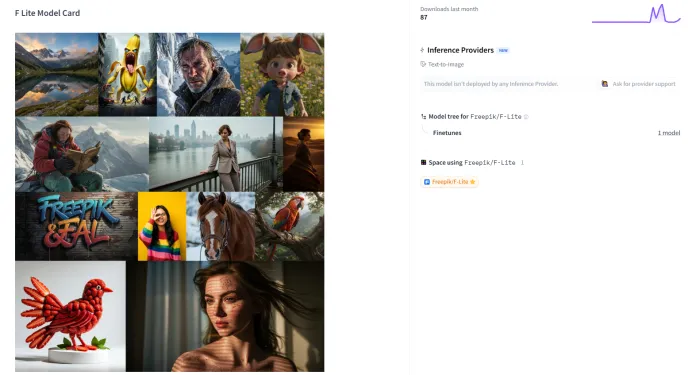
F-Lite是一款基于扩散变换器(Diffusion Transformer)架构的文本到图像生成模型,由Black Forest Labs开发并于2025年正式登陆Hugging Face平台。该模型以10亿参数的轻量化设计,实现了高效、低成本的图像生成能力,支持通过自然语言提示生成高分辨率(最高1024x1024)图像,并具备开源特性,适用于消费级硬件部署。
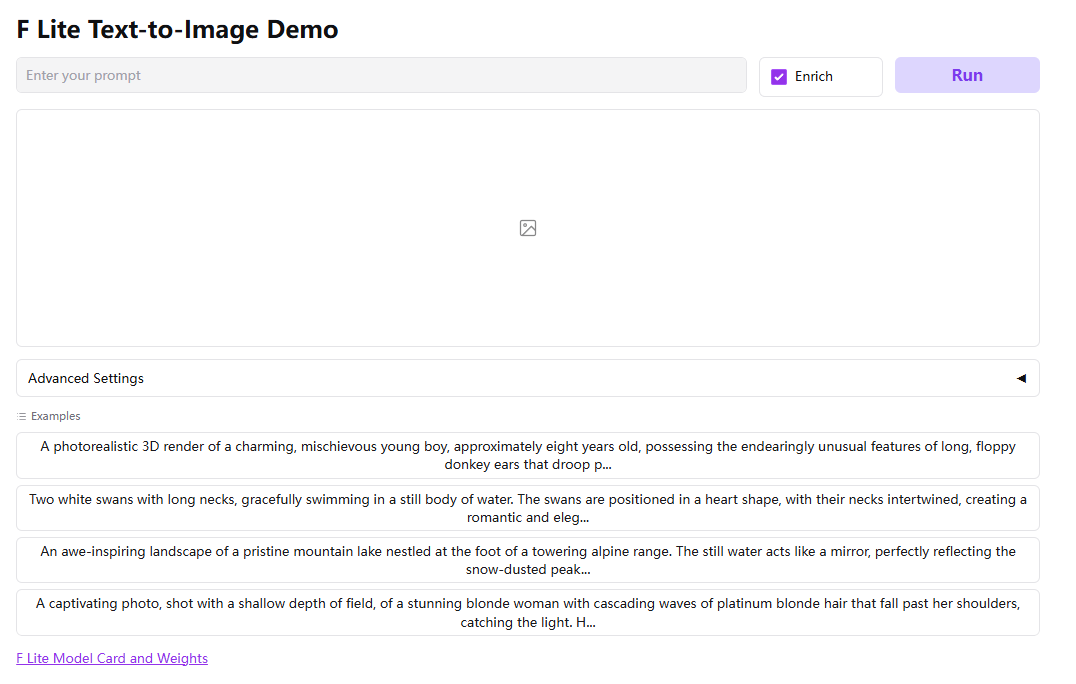
核心优势
- 轻量化设计F-Lite通过优化模型结构,将参数规模压缩至10亿,相比FLUX.1的120亿参数模型,推理效率显著提升,可在RTX3060等中端GPU上流畅运行,显存需求仅需12GB VRAM。
- 高效生成能力采用时间步精炼技术,默认采样步数减少至28步,生成单张高质量图像仅需数秒,推理速度比Stable Diffusion v1.5快约20%。
- 开源与定制化模型检查点与推理代码已通过Hugging Face公开,支持PyTorch与FLAX框架,开发者可自由定制控制模式或微调模型,推动社区创新。
- 量化优化支持int4与bfloat16量化,进一步降低显存占用,适配消费级设备,显著提升模型的可访问性。
主要功能
- 文本到图像生成用户可通过自然语言提示(如“雪山下的未来城市,赛博朋克风格”)生成高分辨率图像,支持复杂场景与风格化需求。
- 控制模式增强兼容深度控制(Depth Control)与Canny边缘控制,通过通道拼接实现类似ControlNet的效果,增强结构控制能力。
- 多模态扩展潜力支持Model Context Protocol(MCP),未来可与Qwen-Agent等框架集成,扩展多模态任务能力。
需求人群
- 开发者与研究者需要轻量化模型进行快速原型验证或学术研究的开发者,可利用F-Lite的开源特性进行二次开发。
- 中小型创作者与工作室独立艺术家、游戏开发者、影视团队等可通过F-Lite降低硬件成本,提升内容生产效率。
- 教育与科普机构教育机构可利用F-Lite生成教学插图或科学场景,增强课堂互动与研究展示。
应用场景
- 数字艺术与NFT快速生成风格化图像,适配OpenSea等平台,助力艺术家提升创作效率。
- 游戏与影视生成概念场景或角色设计,缩短前期美术周期,适合独立开发者与工作室。
- 电商与广告创建产品展示图像,提升Shopify或Instagram营销吸引力。
- 个性化创作为社交媒体生成定制化内容,如节日贺卡或表情包,满足用户分享需求。
使用教程
1.环境准备推荐硬件:CUDA兼容GPU(12GB+ VRAM)安装依赖:运行pip install diffusers==0.10.2 transformers scipy ftfy accelerate
2.模型加载代码
3.生成图像代码
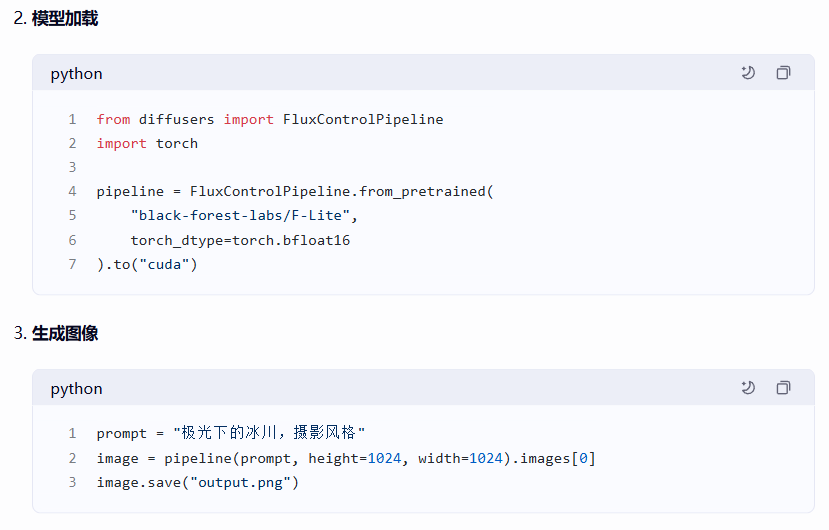
4.高级定制调整参数:通过guidance_scale优化生成质量启用控制模式:结合Canny边缘控制增强结构细节
未来发展
- 技术升级Black Forest Labs计划在下一版本中增强高分辨率生成能力,优化VAE解码器以提升4K分辨率下的细节表现。
- 多模态扩展探索视频生成支持与多语言提示兼容性,推动F-Lite从静态图像生成向动态内容生成扩展。
- 生态整合可能与NVIDIA NIM Operator2.0的微服务框架整合,构建企业级生成工作流;或与Gen-4References的图像混合技术结合,实现动态内容生成。
- 社区化服务长期来看,F-Lite可能推出“生成模板市场”,提供共享提示与模型微调服务,构建类似Hugging Face的生态模式。
结语
F-Lite的推出标志着文本到图像生成技术向轻量化与普及化的迈进。其10亿参数架构与开源支持不仅挑战了SDXL与DALL-E3的高资源需求,还为中小型开发者提供了低门槛创作工具。无论是个人创作者还是企业用户,均可通过F-Lite探索AI图像生成的无限可能。
评论
全部评论

暂无评论
热门推荐



相关推荐
ChatOne
ChatOne是一款由深圳市奇思妙物科技有限公司开发的AI大模型聚合平台,整合国内外主流AI模型(如GPT-4、文心一言等),提供多场景智能交互服务。其核心定位为“一站式AI生产力工具”,通过自然语言交互实现内容创作、知识管理、客服自动化等功能,旨在降低AI技术使用门槛,提升个人与企业效率。
Ming-Omni
Ming-Omni是由Inclusion AI与蚂蚁集团联合推出的开源多模态模型,其核心亮点在于统一处理图像、文本、音频和视频,并支持语音与图像生成,成为首个在模态支持能力上与GPT-4o媲美的开源模型。
360智脑
360智脑是360公司自主研发的认知型通用大模型,依托其在算力、数据和工程化领域的长期积累,集成360GPT大模型、360CV大模型及多模态技术能力,构建起覆盖文本、图像、语音、视频的跨模态生成体系。
SophNet
SophNet是算能科技旗下的云算力平台,专注于提供高性能的AI推理服务。是目前国内DeepSeek API推理速度最快的平台,TPS超过100,是其他平台的3~5 倍,能显著提升用户体验和商业转化率。它提供60余款主流大模型API,涵盖文本、语音、图像、代码、视频等多场景,满足开发者一站式需求。
炉米Lumi
炉米Lumi是由字节跳动推出的一个AI模型分享社区平台,旨在满足日益增长的AI模型交流与应用需求。该平台由字节跳动内部孵化,定位为一个融合模型分享、工作流搭建和模型训练的综合性平台,旨在促进AI技术在各个领域的广泛应用和深入发展。
Dia
Dia是由Nari Labs团队开发的一款拥有1.6亿参数的文本转语音(TTS)模型。它旨在直接从文本提示生成自然对话,并支持包括情绪语调、说话人标记以及(笑)、(咳嗽)、(清嗓子)等非语言音频提示等细致功能。这些功能仅通过纯文本即可实现,使得Dia在语音生成领域具有极高的灵活性和实用性。
World Labs
World Labs是由斯坦福大学教授、“AI教母”李飞飞于2024年创立的AI公司。公司的核心使命是 实现“空间智能”(Spatial Intelligence) ——即让 AI 不仅能识别图像,更能像人类一样理解、推理、生成并与三维物理世界进行交互。
Magi-1
Magi-1是一款由Sand.ai团队研发的自回归视频生成模型。它采用了先进的深度学习技术,通过预测视频块序列(这些视频块是连续帧的固定长度片段)来生成高质量的视频内容。Magi-1不仅支持因果时间建模,还能实现自然的流式生成,为用户提供了极大的创作自由和灵活性。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴