Sonic-3
 1.52w
 0
 0
Sonic-3是美国生成式AI公司Cartesia推出的第三代实时文本转语音(Real-time TTS)模型。它基于自研的State-Space序列架构,在保持极低保真延迟最低90ms的同时,首次在公开API中实现了情绪标签驱动的笑声、呼吸、停顿与多情感强度控制,被业内称为会笑会喊的大语言模型。
直达网站
一、Sonic-3是什么?
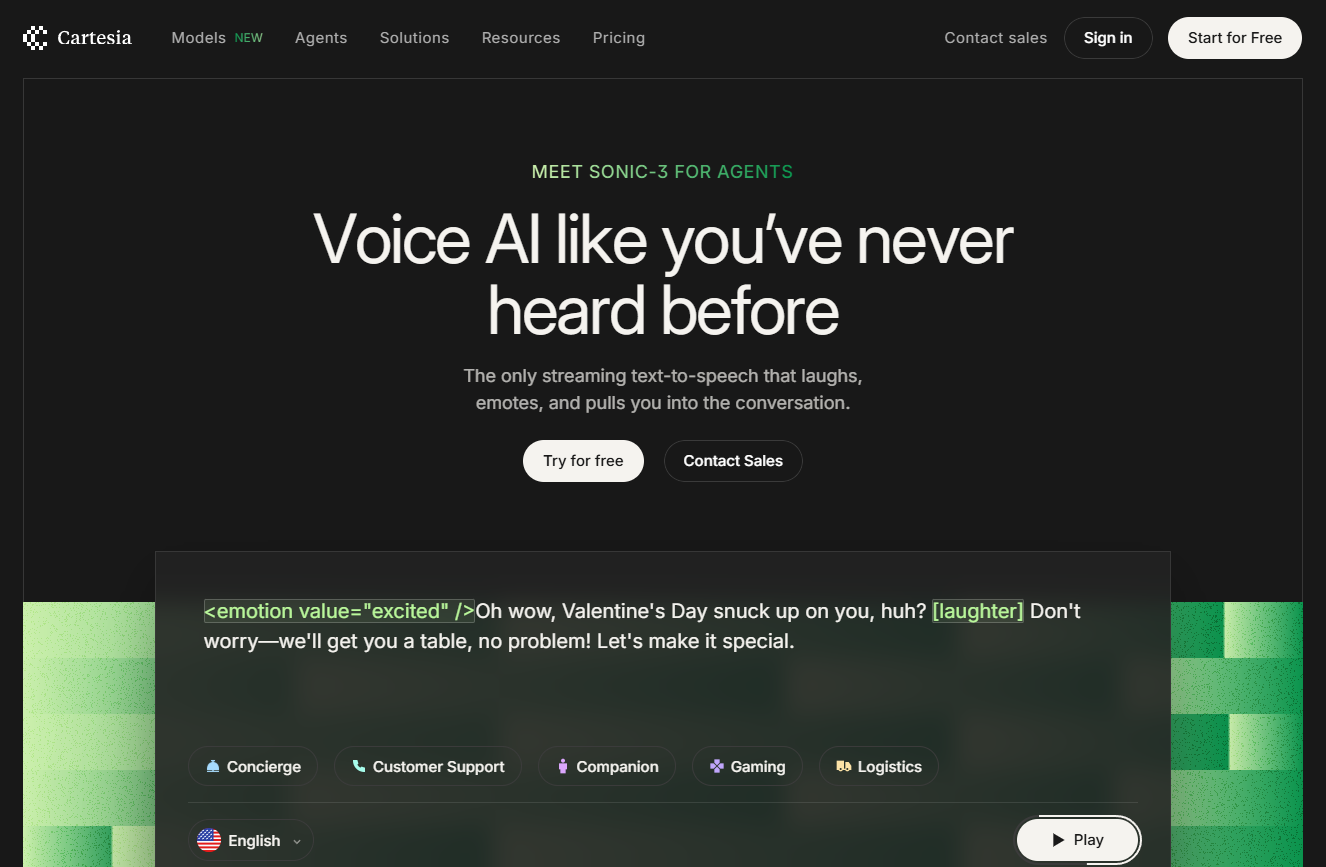
Sonic-3是美国生成式AI公司Cartesia于2024年推出的第三代实时文本转语音(Real-time TTS)模型。它基于自研的State-Space序列架构,在保持极低保真延迟(最低 90 ms)的同时,首次在公开API中实现了「情绪标签驱动」的笑声、呼吸、停顿与多情感强度控制,被业内称为「首款真正会笑、会喘、会兴奋」的语音大模型。
二、核心功能
1. 情感与副语言生成
- 支持 12 种基础情绪(excited、sad、cheerful、empathetic…)
- 内置笑声标签 [laughter],可插入位置、时长与强度
- 支持副语言事件:呼吸、叹气、口型停顿(um/uh)
2. 42种语言母语级发音
- 覆盖全球 95% GDP 市场,包含 9 种印度方言(印地语、泰米尔语等)
- 自动匹配口音与韵律:英式、美式、澳式、拉美西语、葡语等
3. 90ms超低延迟流式输出
- 首包时间 P50 90 ms,P99 160 ms,低于人类眨眼(100 - 150 ms)
- 兼容 WebRTC、RTMP、WebSocket,可在 4G/5G 移动网稳定运行
4. ≤10秒极速音色克隆
- 即时克隆:10 秒音频 → 1 分钟完成部署
- 专业克隆:30 分钟精品数据 → MOS 4.55+,支持企业专属版权隔离
5. 精细化SSML控制
- 可插入
<emotion>、<break>、<prosody>、<phoneme>标签 - 智能缩写解析:NASA 读 /ˈnæsə/,FBI 读字母,COVID 读 /ˈkoʊvɪd/
三、平台优势
1. 企业级合规
SOC 2 Type II、HIPAA、PCI-DSS Level 1 认证,支持 GDPR 数据可删。
2. 并发 & 弹性
自研推理栈 + GPU 池化,单租户支持 10 万路并发,自动水平扩容。
3. 多形态集成
REST/GRPC API、Python/Node/Go SDK、浏览器 Playground、私有化集群。
4. 成本可控
按字符量计费,实时与离线同价;提供 1 万字符/月永久免费层。
四、需求人群
- 对话式 AI 厂商:Chatbot、Voicebot、IPCC 厂商需要低延迟 + 情绪。
- 硬件/IoT:智能眼镜、车载助手、陪伴机器人对端侧延迟敏感。
- 游戏 & 社交:NPC 实时配音、语聊房变声、UGC 短视频配音。
- 医疗 & 教育:患者随访、口语评测,需要 HIPAA/等保合规。
- 跨国公司:一套接口覆盖 40 + 语言,降低本地化成本。
五、应用场景
1. 酒店预订 Voice Agent
用户:"帮我订今晚的情侣桌!"
AI(兴奋 + 笑声):"哈哈,情人节给你来个突袭?没问题,马上锁定海景桌!"
2. 售后客服
检测到用户抱怨关键词 → 自动切换「empathetic」情绪,降低投诉率 18%。
3. 车载多语言导航
同一辆车支持中英印地无缝切换,延迟 < 120 ms,保证驾驶安全。
4. 实时游戏直播
主播文字弹幕 → 即时语音播放,观众可自选角色音色与情绪。
5. 医疗随访机器人
温柔语调解说术后注意事项,支持 HIPAA 数据加密与审计日志。
六、技术特点
- State-Space 主干网络:相比 Transformer 减少 O(n²) 计算,序列越长延迟优势越大。
- 双通道情感推理:文本语义通道 + 纯声学语境通道,保证笑声与词句对齐。
- 自适应韵律预测:基于大规模多语韵律标注,自动匹配重音、语调、停顿。
- 量化与蒸馏:8-bit 权重量化 + 动态批推理,单机 8×A100 可跑 2 万并发流。
- 端到端神经 codec:直接输出 24 kHz 高保真波形,无需传统声码器。
七、性能基准(Cartesia 公开白皮书)
| 指标 | Sonic-3 | 主流竞品 A | 竞品 B |
|---|---|---|---|
| 首包延迟 P99 | 160 ms | 580 ms | 390 ms |
| 自然度 MOS | 4.61 | 4.34 | 4.28 |
| 英语单词错误率 WER | 0.9% | 2.3% | 1.8% |
| 笑声时间对齐误差 | ±30 ms | 不支持 | ±150 ms |
八、如何使用
1. 注册免费层
访问 https://play.cartesia.ai/sign-up 送 10 千字符。
2. 浏览器 Playground
输入文本,加 <emotion value="excited"> 标签,一键试听。
3. 代码示例(Python SDK)
pythonimport cartesia
client = cartesia.Client(api_key="YOUR_KEY")
audio = client.tts.speak(
    text="<emotion value='laugh'>Wow, you surprised me!</emotion>[laughter]",
    voice_id="sonic-3-en-us",
    stream=True
)
九、总结
Sonic-3把「实时性」「情感表现」「多语母语」三大刚需一次性打包进低门槛 API,为对话式AI、IoT、游戏、医疗等行业提供了可落地、可扩展、可合规的语音解决方案。如果你正在寻找一款真正「像人一样会笑」的 TTS 引擎,Sonic-3 值得第一时间体验。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区
AITOP100平台官方交流社群二维码:
评论
全部评论

暂无评论
热门推荐



相关推荐
OmniTalker
OmniTalker是阿里通义实验室开发的一款基于深度学习和多模态融合技术的新型数字人视频生成大模型。它能够通过上传一段参考视频,实现对视频中人物的表情、声音和说话风格的精准模仿,从而生成高度逼真的数字人视频。
火山方舟
火山方舟是火山引擎旗下的大模型服务平台,定位为面向企业提供全面的模型即服务(MaaS,Model-as-a- Service)解决方案。它汇聚百川智能、出门问问、复旦大学MOSS、IDEA研究院、澜舟科技、MiniMax、智谱AI等多家 AI 科技公司及科研院所的大模型,打破模型资源分散的局面。
纳米AI搜索
纳米AI搜索(简称纳米搜索)是由360集团近期推出的一款基于先进AI技术构建的多模态内容创作引擎,该产品已上架至苹果App Store和安卓应用商店,直接对标百度、阿里夸克、秘塔AI、Perplexity AI等多个AI搜索类产品。
魔多
魔多AI社区是厚德云旗下一个专为AI创作者打造的趣玩社区,集算力GPU云服务器、模型与镜像分享、在线工作流、在线模型训练、算力激励等为一体的AI创作生态社区
Ming-Omni
Ming-Omni是由Inclusion AI与蚂蚁集团联合推出的开源多模态模型,其核心亮点在于统一处理图像、文本、音频和视频,并支持语音与图像生成,成为首个在模态支持能力上与GPT-4o媲美的开源模型。
知达AI
知达AI是国内领先的全学段教育多模态大模型平台,以自研教育垂类大模型为核心,覆盖K12、职教、特教、高教四大场景。平台集成智能备课、出题批改、学情分析、私有知识库等全流程工具,融合RAG检索增强与多模态交互技术,保障内容精准合规。已服务18万用户、落地千余案例,助力教师减负增效与院校数字化转型
Genie 3 - 世界模型
Google DeepMind最新发布的Genie 3 AI世界模型,能够通过文本提示实时生成可交互3D虚拟世界。24fps流畅运行,支持物理建模、自然环境模拟等功能,为游戏开发、教育培训带来革命性变化。
Kimi K3
Kimi K3全球首款2.8万亿参数原生多模态MoE大模型。采用896专家稀疏架构、自研KDA注意力机制与MoonViT-V2视觉编码器,支持100万Token超长上下文及图文视频一体化输入。模型在编程智能体、行业研究、多模态理解等赛道位列开源第一。
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴