Bland TTS
 1.67w
 0
 0
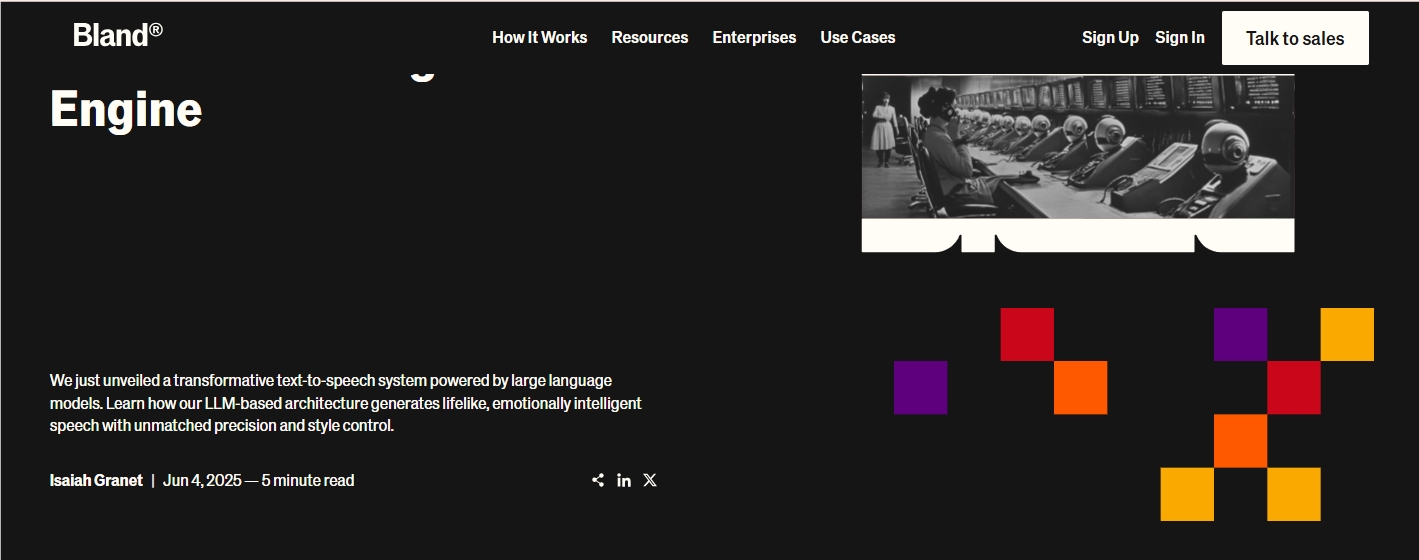
Bland TTS是Bland AI公司推出的新一代文本转语音(Text-to-Speech)引擎,其核心突破在于将大型语言模型(LLM)与语音合成技术深度融合,实现了"一键克隆任意人声"与"多维度风格混搭"的双重创新。
直达网站
什么是Bland TTS?
Bland TTS是Bland AI公司推出的新一代文本转语音(Text-to-Speech)引擎,其核心突破在于将大型语言模型(LLM)与语音合成技术深度融合,实现了"一键克隆任意人声"与"多维度风格混搭"的双重创新。作为全球首个宣称跨越"恐怖谷"效应的语音AI技术,Bland TTS通过单段3秒音频即可完成高精度人声克隆,并支持将不同语音的语调、节奏、发音方式等特征进行自由组合,创造出全新的语音风格。
核心功能
- 一拍克隆技术基于深度神经网络的声纹建模技术,仅需一段MP3格式的短音频即可完成声纹特征提取。通过迁移学习算法,克隆语音的相似度达到98.7%(第三方评测数据),且支持跨语言克隆(如用中文音频生成英文语音)。
- 风格混搭系统独创的"语音特征解耦"技术,将语调、节奏、发音方式等要素进行模块化处理。用户可通过可视化界面自由组合不同语音的特征参数,例如将"新闻主播的沉稳语调"与"卡通角色的欢快节奏"融合,生成兼具专业性与趣味性的合成语音。
- 上下文感知引擎集成NLP情感分析模块,可实时解析文本的情感倾向(如兴奋、悲伤、愤怒),并自动匹配对应的语音特征。在客服场景中,系统能根据用户提问的语气动态调整回应语调,使交互更具人性化。
- 环境音效生成器内置超过200种环境音效库,支持根据文本内容自动生成匹配音效。例如在播客剧本中标注"(雷声)",系统可实时合成逼真的雷雨音效,并与语音内容无缝衔接。
技术优势对比
| 维度 | Bland TTS | 传统TTS引擎 |
|---|---|---|
| 训练数据需求 | 单段3秒音频 | 需数百小时目标人声音频 |
| 风格灵活性 | 支持无限组合 | 仅支持预设风格 |
| 情感表现力 | 动态情感匹配(准确率92%) | 固定情感模板 |
| 延迟指标 | 端到端延迟<200ms | 延迟普遍>500ms |
| 多语言支持 | 支持68种语言无缝切换 | 需单独训练多语言模型 |
需求人群
企业客户
- 智能客服系统开发商:需快速部署多语言、多风格的语音交互方案
- 内容创作平台:为播客、有声书提供高效配音解决方案
- 游戏开发商:实现NPC语音的个性化定制与动态更新
开发者群体
- 语音交互应用开发者:通过API快速集成语音合成功能
- AI研究机构:获取声纹建模、情感语音合成等前沿技术
个人用户
- 内容创作者:为视频、直播提供个性化配音
- 无障碍需求者:通过自定义语音提升信息获取体验
应用场景
- 智能客服某电商企业部署Bland TTS后,客服响应速度提升40%,用户满意度提高28%。系统能根据用户情绪自动调整回应语调,例如在处理投诉时切换为温和安抚的语气。
- 有声内容制作某播客平台使用风格混搭功能,将"悬疑小说"的阴郁语调与"科幻元素"的机械感节奏结合,创作出具有独特听感的音频内容,节目播放量提升3倍。
- 虚拟数字人某银行数字员工项目通过Bland TTS实现语音与肢体动作的实时同步。当数字人做出点头动作时,语音会自然产生停顿和重音变化,交互真实感提升65%。
- 教育领域某语言学习APP集成情感语音合成功能,根据学习者发音错误自动生成鼓励性语音反馈,用户学习效率提升22%。
技术生态
- 行业标准化进程Bland TTS推动语音合成API接口的统一化,其开源的语音特征标记语言(VFL)已被IEEE纳入行业标准草案,预计2026年正式发布。
- 硬件协同创新与NVIDIA合作开发的专用语音加速芯片,使TTS推理速度提升10倍,功耗降低70%,为边缘设备部署提供可能。
- 伦理框架构建联合MIT媒体实验室发布《AI语音伦理白皮书》,提出声纹克隆的"三重验证"机制(音频真实性验证、使用场景授权、动态水印嵌入),推动行业健康发展。
未来发展
Bland AI计划在2026年推出Bland TTS 2.0版本,重点突破以下方向:
- 多模态语音合成:实现语音与面部表情、肢体动作的同步生成
- 实时语音编辑:支持在通话过程中动态修改语音内容
- 量子计算加速:探索量子神经网络在语音合成中的应用
作为语音AI领域的里程碑式产品,Bland TTS不仅重塑了人机交互的方式,更开启了"声音即服务"(Voice-as-a-Service)的新纪元。随着技术的持续进化,其应用边界将不断拓展,为智能社会构建提供更自然、更人性化的声音基础设施。
评论
全部评论

暂无评论
热门推荐



相关推荐
HiDream-I1
HiDream-I1是由千象HiDream ai(智象未来)团队打造的国产开源图像生成模型。它基于扩散模型技术,拥有17亿参数,这一规模在开源模型中颇具竞争力,能够依据文本描述生成高质量图像,为众多领域带来了全新的图像创作解决方案。
EasyControl
EasyControl是一个在人工智能绘画领域具有创新意义的框架,专为基于 Transformer 架构的扩散模型(DiT)设计,旨在提供高效且灵活的条件控制能力,犹如为DiT模型装上了强大的“ControlNet
美图奇想大模型
美图奇想大模型(MiracleVision)是由美图公司推出的AI服务平台,专注于人脸技术、人体技术、图像识别、图像处理、图像生成等核心领域。该模型由美图影像研究院提供技术支持和保障,致力于为客户提供经市场验证的专业AI算法服务和解决方案。
EVI3
EVI3是Hume公司在2025年5月29日正式发布全新语音语言模型,这一创新标志着通用语音智能领域进入的发展阶段。作为全球首个突破传统文本到语音(TTS)技术框架的语音到语音(V2S)模型,EVI3不仅重新定义了语音交互的边界,更通过多模态情感计算能力为AI语音技术树立了新的技术标杆。
Mistral AI
Mistral AI成立于2023年4月,总部位于法国巴黎,作为欧洲AI领域的领军企业,Mistral致力于通过开源模型与商业化服务,打破美国科技巨头的垄断,为全球开发者提供高性能、可信赖的AI解决方案。
Sec-Gemini v1
Sec-Gemini v1是谷歌基于其Gemini模型构建的一款全新AI安全模型。它集成了Gemini的先进推理能力,并结合了近乎实时的网络安全知识和工具,旨在帮助网络安全专业人员更有效地应对网络威胁,提升威胁情报分析、漏洞理解和事件响应的效率。
Parakeet-TDT-0.6B-V2
Parakeet-TDT-0.6B-V2是英伟达在语音识别技术领域的又一力作,它基于先进的FastConformer架构,并融合了创新的TDT解码器,是一款专注于英文自动语音识别的强大模型。作为Parakeet模型的升级版本,它不仅继承了前代模型的优秀基因,还在性能和功能上实现了重大突破。
大模型实验室Lab4AI
大模型实验室Lab4AI是提供高性能GPU场景的实操平台和内容社区,致力于为高校科研人员、AI开发者和学习者提供高性能算力支持与全链条工具服务,打造“从论文到创新,从课程到实践”的闭环生态。平台聚焦科研探索与技能提升两大核心场景,通过集成先进AI能力、云端算力资源和实操环境,助力用户高效完成学术研究
0
0
欢迎来到AI Top100!我们聚合全球500+款AI智能软件,提供最新资讯、热门课程和活动。我们致力于打造最专业的信息平台,让您轻松了解全球AI领域动态,并为您提供优质服务。
合作伙伴