10月28日,英伟达正式开源语音转录模型 Nemotron 3.5 Transcribe。
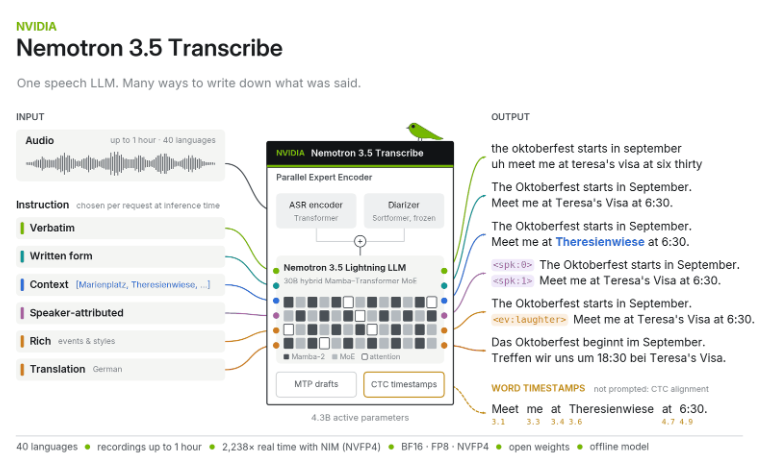
与传统语音识别模型不同,英伟达将其定位为语音增强语言模型(Speech-Augmented Language Model, SALM):它不只是语音转文字,还支持用自然语言指令,自由控制转录风格、格式与识别侧重点。
英伟达同步放出配套数据整理管线 Granary v2,公开数据集覆盖463,062小时音频、48种语言、16个源语料库,可直接用于模型微调与行业场景适配。
技术报告:research.nvidia.com/labs/nemotron/NVIDIA-Nemotron-3.5-Transcribe
一、模型架构:340亿总参数,推理仅激活43亿
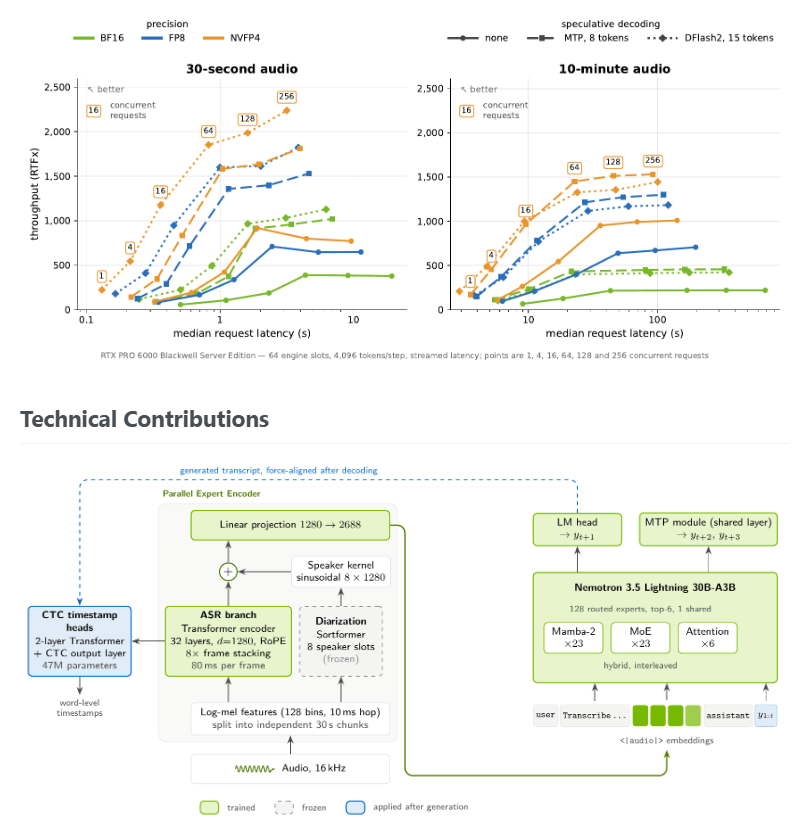
Nemotron 3.5 Transcribe 采用混合专家MoE架构,整体由三部分组成:
- Transformer语音编码器
- 冻结版Nemotron 3 Diarization说话人分离模型
- Nemotron 3.5 Lightning 30B-A3B MoE混合Mamba-Transformer语言模型
- 总参数量:340亿
- 单次前向推理激活参数:仅43亿
该设计把说话人分离能力嵌入编码器特征,英伟达称:这是首个在说话人归属转录任务上超越专用级联系统的SALM模型。
音频处理能力
- 单次最长处理:1小时长录音
- 支持转录语种:40种语言,其中31种支持与英语双向互译
- 说话人归属:覆盖13种语言,最多同时区分8位说话人,自动给每段发言打上说话人标签
二、性能表现:多榜单登顶,重叠语音分轨能力断层领先
提示:不同评测平台口径不一样,横向对比必须保持评测条件一致。
1. 通用语音识别(ASR)
- Hugging Face Open ASR排行榜
英语9项测试集平均WER:4.71%
多语言7项测试集平均WER:4.62%
位列榜单开放权重模型第一名。
注:网传中文5.33%并非官方报告数据,属于特定子集测试结果。 - Artificial Analysis非流式评测
最优AA-WER低至2.8%,与竞品并列榜首;竞品激活参数量是它的6倍(24B vs 4B)。
补充:同一模型在不同服务端点得分会波动,榜单另有3.4%版本,对比时务必统一口径。
2. 核心强项:重叠语音+说话人归属(Diarization)
这是本模型最大优势,大幅领先付费商用服务:
- VoiceArena Diarization-Bench(2–8人多人重叠会话)
cpWER(同时惩罚转录错误+说话人标注错误):32.4%,14款参评系统排名第一;
对比付费服务Deepgram Nova-3:71.9%;
漏词率仅8.32%,远低于参评系统31%的中位数水平。 - David AI 21语种说话人分离基准
DER分离错误率:18.26%,14款模型里最低。
竞品横向对比
Mistral Voxtral Small在干净朗读语音上略占优势(2.1% vs 2.8%~3.4%);
但在嘈杂真人对话场景AgentTalk中,Nemotron反超:1.8% vs 2.3%。
原因:Voxtral是专用ASR模型,优化偏向纯净朗读音频;Nemotron以大语言模型为底座,在口语闲聊、多人抢话等真实场景稳定性更强。
三、核心亮点:可提示转录,用自然语言自由控制输出
Nemotron 3.5 Transcribe最大创新是Promptable可提示转录。
转录前可以用自然语言下达指令,自定义输出规则:
- 输出纯口语初稿,还是整理好的书面文稿
- 数字保留口语读法,还是自动转为阿拉伯数字
- 开启/关闭说话人标签、自动双语翻译
- 导入专业术语词表,大幅降低专有名词识别错误
实测优化效果
- 导入专有名词词表后,ContextASR-Bench下命名实体错误率下降83%(降至原来1/6)。
- 医疗场景微调案例:印度医生语音识别,词错误率从22.44%降到12.17%,降幅45.8%;整套微调流程在单张GB300显卡上仅需14GPU小时。
附加能力
支持词级时间戳+说话人标签对齐:轻量级CTC适配器把文字逐词匹配到音频时间轴,完美适配长时间会议录音、多人重叠对话素材。
四、部署方案与适用边界
1. 开源许可&部署方式
- 许可证:OpenMDW-1.1,允许商业免费使用
- 部署方案:
① vLLM实现服务化部署;
② NeMo-Speech.cpp完成本地端侧运行 - 硬件兼容:Jetson AGX Thor、DGX Spark、Blackwell系列数据中心GPU,单卡即可运行。
2. 明确局限(重要)
- 仅支持离线文件转录,不支持实时流式识别,不适合直播字幕、实时通话场景。
- BF16精度推理显存占用约80GB(单张H100);量化版本可以降低显存门槛,但会牺牲一部分识别精度。
五、总结适用场景
Nemotron 3.5 Transcribe把语音识别从“单纯文字转写”升级为“可控生成式转录”。
✅ 优势场景:
多人会议纪要、访谈录音整理、多语种音频归档、多人重叠语音自动分轨打标签。
❌ 不适合场景:
低延迟实时字幕、纯朗读干净音频追求极致WER指标。
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: