你有没有遇到过这种事:公司里的 AI 助手,换个部门就像「失忆」了?其实不少企业的智能体都卡在同一个地方——它们算得上聪明,却读不懂自家公司的业务。
合合信息旗下的企业 AI 基础设施 TextIn 最近推出企业知识服务引擎,想给各类企业 AI Agent 造一个共享的「记忆库」,去碰一碰「智能体业务理解难题」这道题。
智能体的「失忆」困局
很多企业上了 AI Agent,刚用时觉得真香,用着用着就露怯。销售那边的智能体能把产品参数讲明白,到了售后就答不上来;财务的流程机器人,换个审批场景就抓瞎。说白了,这些智能体各自为政,谁也没把公司的业务知识真正存下来。
行业里常把这种状况叫作「数据孤岛」,搁在智能体身上就是「记忆断裂」。每个 Agent 像刚入职的新人,每次对话都从零开始,过去踩过的坑、攒下的经验全部清零。更要命的是,业务知识散在文档、表格、聊天记录里,格式五花八门,智能体根本喂不进嘴。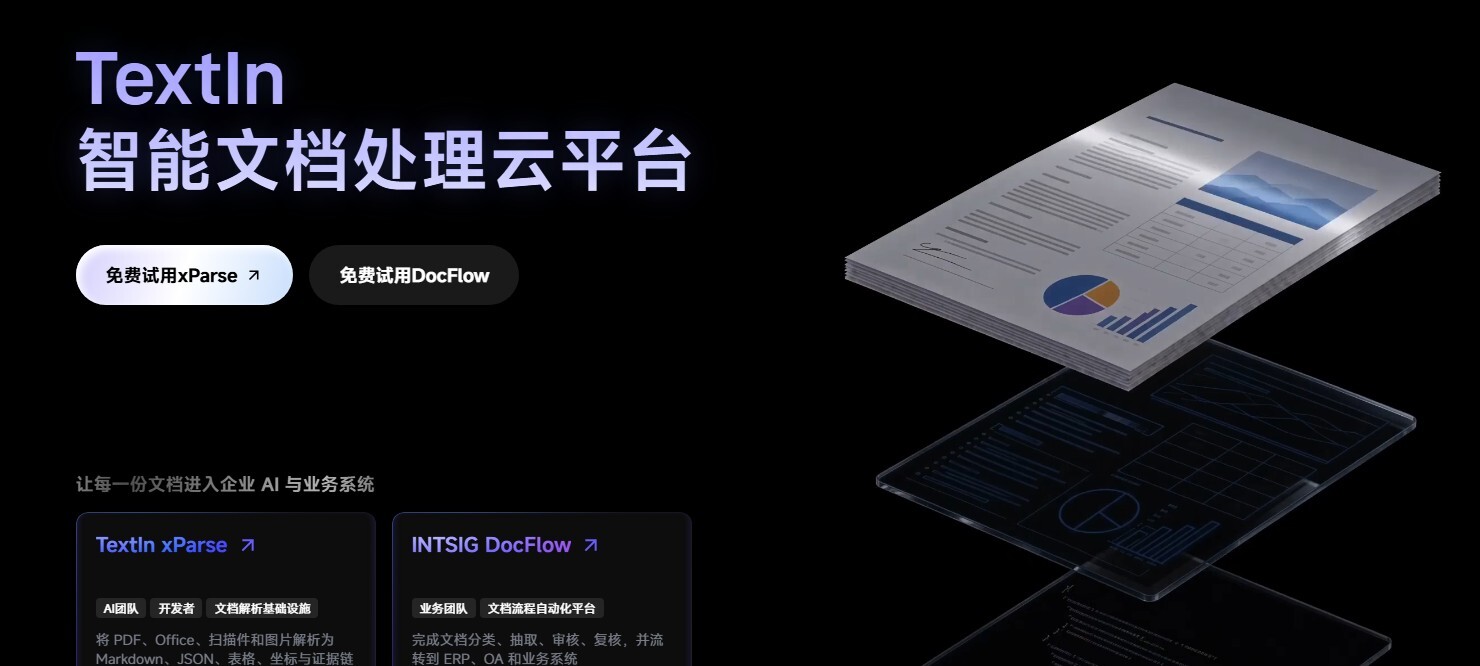
所以企业越用越觉得,AI 是聪明,但「不懂我们公司」。这大概就是 TextIn 这次想解决的第一道坎。
一个共享的「记忆库」是什么
TextIn 这次推出的企业知识服务引擎,核心思路其实不复杂:别让每个 Agent 各记各的,统一建一个大家都能读的「记忆库」。按合合信息方面的说法,这套引擎面向各类企业 AI Agent,把散落的企业知识先做清洗、结构化,再集中存起来,智能体调用时直接来「记忆库」取,不用每次重新训练。
打个比方,过去每个部门养自己的「小秘书」,现在公司请了个总资料员,谁要查什么,对方一站式给到。对想铺开多个智能体的企业来说,这个思路能少做不少重复活。
需要说明的是,这套引擎具体支持哪些数据格式、如何做权限隔离、底层用的是什么检索方案,公开资料暂未细说,相关细节待核实。但「共享记忆」这个方向,确实戳中了不少企业上 AI 时的真实痛点。
怎么破解「业务理解」这道题
回到开头那句话——智能体真正卡在「不懂业务」。TextIn 的「记忆库」想做的,是把企业自己的规则、流程、术语、历史案例沉淀成可检索的知识,让 Agent 在开口前先「翻一翻公司笔记」。
这样一来,同一个智能体在销售、售后、财务不同场景里,调的是同一套业务底稿,理解自然更稳,也不容易前后矛盾。不过得说清楚,知识引擎能提升一致性,但业务理解的上限还取决于知识本身的质量;如果企业塞进去的是过期文档,出来的答案照样会跑偏(这点属常识推断,非官方结论)。
所以对于「破解智能体业务理解难题」这个说法,更稳妥的表述或许是「缓解」而非「一步到位彻底解决」。技术能补上记忆的缺口,但补不上的那部分,仍要靠企业自己把知识管明白。
对企业来说意味着什么
落到企业视角,共享「记忆库」最大的好处是省事和复用。过去每接一个 AI 项目,团队都要重新搬一遍知识、重新接一遍系统,重复劳动不少;如果「记忆库」真能做成公共底座,新 Agent 只要对接一次就能上岗,开发和运维成本有望降下来。
当然,这事能不能成,还得看落地——接入是否顺、维护是否轻、和小模型大模型能否都兼容,都是后面要验证的。据公开信息,TextIn 是合合信息旗下的企业 AI 基础设施,本身在文档识别、智能处理上有积累(基础能力描述,具体能力待核实)。
对想上 AI 又怕「各自为战」的企业,这类知识引擎值得留意。它未必是银弹,但至少把「让 AI 懂业务」这件事,从口号拉回了可落地的工程层面。
别把它当成万能钥匙
补一句实在话:知识引擎能补上“记不住”的缺口,却补不了“知识本身不对”的坑。企业要是连自己的流程文档都没理清,塞进去一堆过期、矛盾的资料,引擎再聪明也只能照着错的输出。所以这类工具上线前,往往得先做一轮知识梳理,这部分活儿省不掉。
一句话总结:给智能体一个共享「记忆库」,或许是企业 AI 真正「懂业务」的第一步。如果你也在看企业 AI 落地,欢迎在评论区聊聊你遇到的卡点。