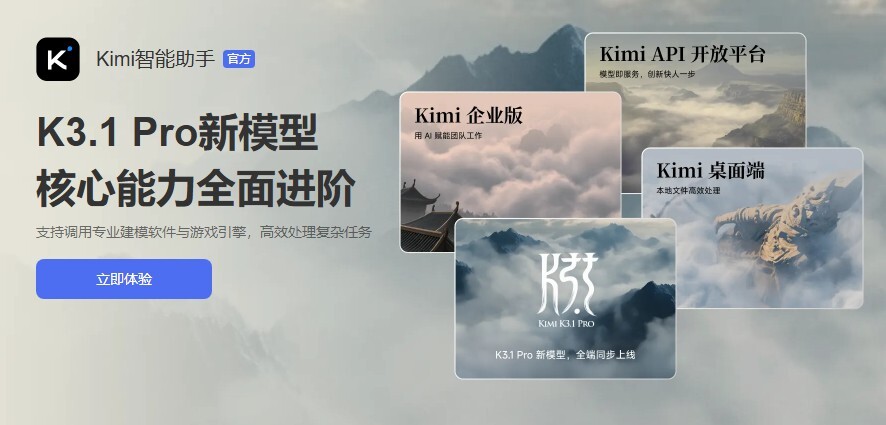
月之暗面今天又出手了。Kimi K3.1 Pro 正式发布,官方口径里,这是公司"迄今能力最强"的模型。一句话,Kimi 的旗舰位子,换新人坐了。大模型这行有意思的地方就在这:隔三差五就有新东西冒出来,上一波的"最强"很快就成了旧闻。所以看到"迄今最强"这种说法,先别激动,把它当成一句产品定位就好,真正好不好用,还得往后看。
「3 万亿级参数」,到底意味着什么
这次 K3.1 Pro 最显眼的一个数字,是「3 万亿级参数」。这个体量在国内已公开的大模型里属于第一梯队,放到全球范围也排得上号。参数多,通常说明模型能记住、能关联的信息更丰富,面对复杂任务时理解也会更稳一点。打个比方,参数像是模型的"脑容量",装得下更多知识,处理长链条的推理时不容易中途跑偏。
但参数规模和实际表现之间还有距离,不是数字大就一定好用。同样都是万亿级,架构怎么搭、数据怎么训、对齐做得细不细,都会拉开差距。具体跑分我们暂时没拿到,待核实。月之暗面把它放在 K 系列旗舰位置,明显是想把长文本、强推理这些场景继续做深。对普通用户来说,最直接的感受可能是:同样一个问题,它给出的回答更连贯、更少"翻车"。
不过到底强多少、强在哪些地方,还是得等第三方实测和日常使用来回答,光看参数说不了话。我们也会持续留意后续评测,有结论再跟大家聊。
「100 万上下文」,长文档终于不用切了
「100 万上下文」是这次另一个重点。说得直白些,模型一次能"看见"的文本长度到了 100 万字这个量级。这是什么概念?一本厚点的书、一整年的聊天记录、或者好几份叠在一起的财报,都能一次性塞进去。
以前处理长材料,常常要分段喂进去,前后容易接不上,关键细节也容易丢。比如你让它读一份 50 页的合同再回答某个条款,老模型可能只"记得"前面几页,后面说的什么它就当没看见。现在把整份材料一次性丢进去,它更有机会把握全局,回答时也更能前后呼应,而不是东一榔头西一棒槌。
对做研究、读合同、扒长论文的人,这是个实打实的省力点。再也不用自己先当"人肉摘要机",把材料压成几百字再喂给模型。你可以直接把一整本书丢进去问"这本书第三章讲了什么",它大概率能给个像样的回答。当然,上下文长不代表一定理解得准,材料太多时模型也可能抓错重点,或者把远处的细节记混。这部分能力到底稳不稳,同样要实际用起来才知道,不能只看数字漂亮。
同步推出高速版,给"等不及"的人
月之暗面这次没只发一个模型,还同步推出了高速版 Kimi K3.1 Pro Highspeed。看名字就知道,它主打一个"快"。旗舰版追求能力强,高速版追求响应快,两者像是互补的一对:一个负责把难题做对,一个负责把答案快点递到手边。
这种"双线并行"的打法,其实越来越常见。同一个底层能力,按不同需求拆成两个产品,比硬塞进一个模型里更省心。你想认真啃一道难题,就开旗舰版慢慢磨;只是想查个天气、改个句子、快速要个思路,高速版明显更顺手,毕竟很多人要的是"马上能用",不是"慢慢想清楚"。
具体提速多少、和旗舰版在质量上差多远,官方还没给详细对比,我们标记为待核实。对日常聊天、快速查资料、写个短文案这类轻量场景,高速版大概率更合适。一个求好,一个求快,大家按自己的需要挑就好,不用非得追着最强的那个跑。
这次发布,放进行业里怎么看
把 K3.1 Pro 和高速版放一起看,月之暗面的思路其实挺清楚:不再只拼一个"最强",而是按使用场景把产品线拉开。能力强和速度快,本来就是两种需求,硬塞进一个模型里往往两头不讨好。今年以来,国内几家大模型公司都在往"旗舰 + 轻量/高速"的组合上靠,Kimi 这步不算意外。
对用户来说,选择变多了是好事,但也意味着要花点心思想清楚自己到底要什么。过去大家习惯问"哪个模型最好",现在更该问"哪个模型最适合我手头这件事"。这是行业成熟的一点信号。它说明厂商也开始承认:没有谁能在所有任务上通吃,分场景做产品反而更诚实。
至于 K3.1 Pro 的真实水平,建议等一波公开评测和亲身试用再下结论,别急着跟着热闹跑。参数和上下文长度给了它一个不错的下限,但上限在哪,得靠真用才知道。我们会保持关注,等实测出来再补一篇。也欢迎用过的朋友在评论区说说真实体感,比任何宣传都管用。
月之暗面这次把 K3.1 Pro 和高速版一起端上来,旗舰看能力、高速看效率,思路挺清楚。你更关心"够不够强"还是"够不够快"?
欢迎在评论区聊聊。
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: