国产大模型又往前挪了一步。科大讯飞这次发布了「讯飞星火 X2.6」端云一体大模型,主打一个说法:用全国产算力,也能把代码和智能体能力跑出来。效率还提了一截,具体多少,往下看。
一、先弄明白「端云一体」是啥
端云一体,听着像发布会黑话,其实拆开很好懂。模型能力同时放在「端」和「云」两端。端,是你手边的设备,手机、电脑、甚至车机;云,是远端的服务器集群。两端不是各干各的,而是协同:简单请求本地就处理了,复杂任务再甩给云端。
这么做的好处很实在。一来响应快,不用每次都往云上跑一圈;二来省流量、少暴露隐私,一些敏感数据留在本地更稳妥;三来在弱网或者离线场景,端侧也能顶一阵。
讯飞把 X2.6 定位成「端云一体」大模型,说明它不只想在机房里跑,也在盘算往各类终端落。对普通用户来说,端云一体最直观的体验,大概是手机上也能用上更跟手、更省流量的模型,而不是每次都要联网等转圈。
不过话说回来,哪些设备会首批搭载、端侧推理的速度和精度损耗能不能接受,目前公开材料还没讲透(待核实)。这点咱们先记着,等后续有实测再补。
二、「全国产算力」五个字,分量不轻
这次被反复强调的一句是:X2.6 是首次基于「全国产算力」实现代码和智能体能力的突破。重点在「全国产」三个字,从底层芯片、加速卡,到上面的训练框架和工具链,尽量不倚仗国外硬件。
为什么这事值得单独拎出来说?因为大模型是个吃算力的怪物。训练一次动辄成百上千张卡连跑很久,哪一步卡脖子都不行。过去几年高端 AI 芯片供给受限,行业一直在问:国产算力栈到底能不能撑起前沿大模型?讯飞这次宣称跑通了,等于给这条技术路线递了一份样本。
但也要冷静。官方口径是「宣称」和「突破」,真正的训练成本、稳定性、故障率,还得看长期运行和第三方复现(待核实)。国产算力从「能用」到「好用」,中间还有不少工程坑要填。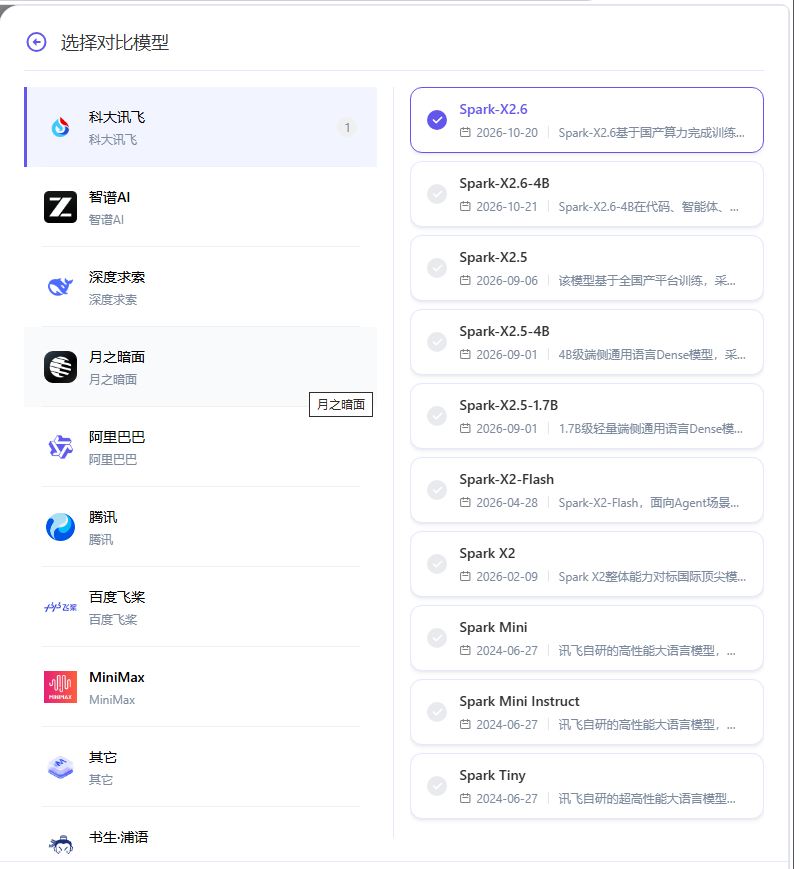
三、代码和智能体,是两块主战场
能力上的突破,集中在两个方向:写代码,和做智能体。
代码能力好理解。现在的 coding 模型,不只是补全几行,而是能读整个代码仓库、理解项目结构、补函数、改 bug、写测试,甚至帮忙做 code review。对开发者来说,这是天天用得上的东西,也是各家大模型争着秀肌肉的地方。
智能体(agent)则是另一回事。它让模型从「你问我答」升级成「你给目标、它来办事」:自己拆任务、选工具、调接口、看结果、再调整,一步步把活干完。比如让它「把这份文档整理成表格并发邮件」,它能自己串起来。
讯飞把 X2.6 的突破点压在这两个方向上,选得不算偏,这恰好是当下大模型最卷、也最贴近真实生产力的两处。对写代码的人,模型能不能真正读懂自家项目、而不是只写出能跑的片段,是判好坏的分水岭;对想用智能体的人,关心的则是它会不会中途卡壳、乱调工具。
只是「突破」到什么水位、跟同级别模型横比差多少,发布会没给太多可比数据。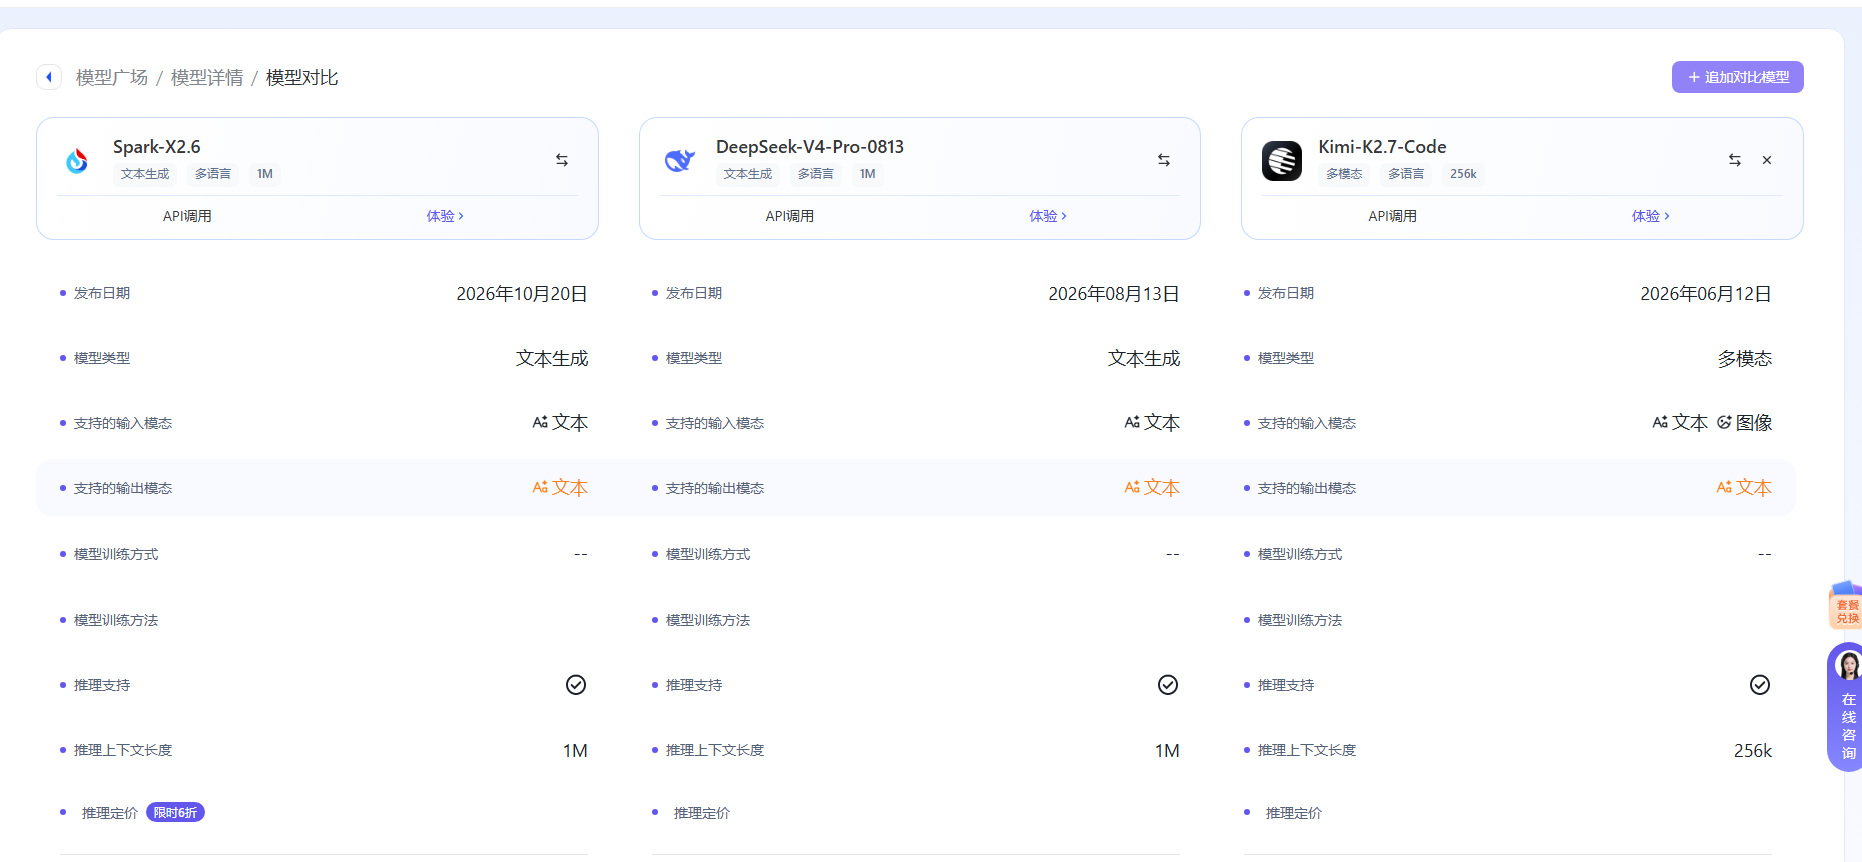
四、超长上下文,训练效率约翻 4 倍
最后说效率这件事。官方提到,在「超长上下文」场景下,X2.6 的训练效率相比此前提升约 4 倍。翻译成大白话:同样长的输入、同样规模的训练,现在大概只用原来四分之一的时间。
这好处是双向的。对做模型的人,省的是真金白银的算力和时间;对用模型的人,更长的上下文意味着它能「记住」更多前文,读长报告、啃长代码、跟长对话,都不会刚聊两句就忘了开头。
当然,数字得看语境。4 倍是官方给出的口径,真实收益取决于在什么任务、什么硬件配置下测,以及「效率」具体指训练吞吐还是端到端成本(待核实)。咱们先把它当一个乐观信号收着。
国产算力、端云一体、代码与智能体,讯飞这回把牌摊得不小。是骡子是马,等一波第三方实测就清楚了。
如果你也在看大模型国产化的走向,不妨点个关注,后面咱们接着拆。