用 AI 助手最烦的一件事,是它"过目即忘"。昨天刚交代过的偏好,今天开新对话又要重新讲一遍;跨工具、跨会话之后,上下文基本清零,Agent 只能从零开始理解你。这不是模型不够聪明,而是记忆这件事,过去一直没人好好做。
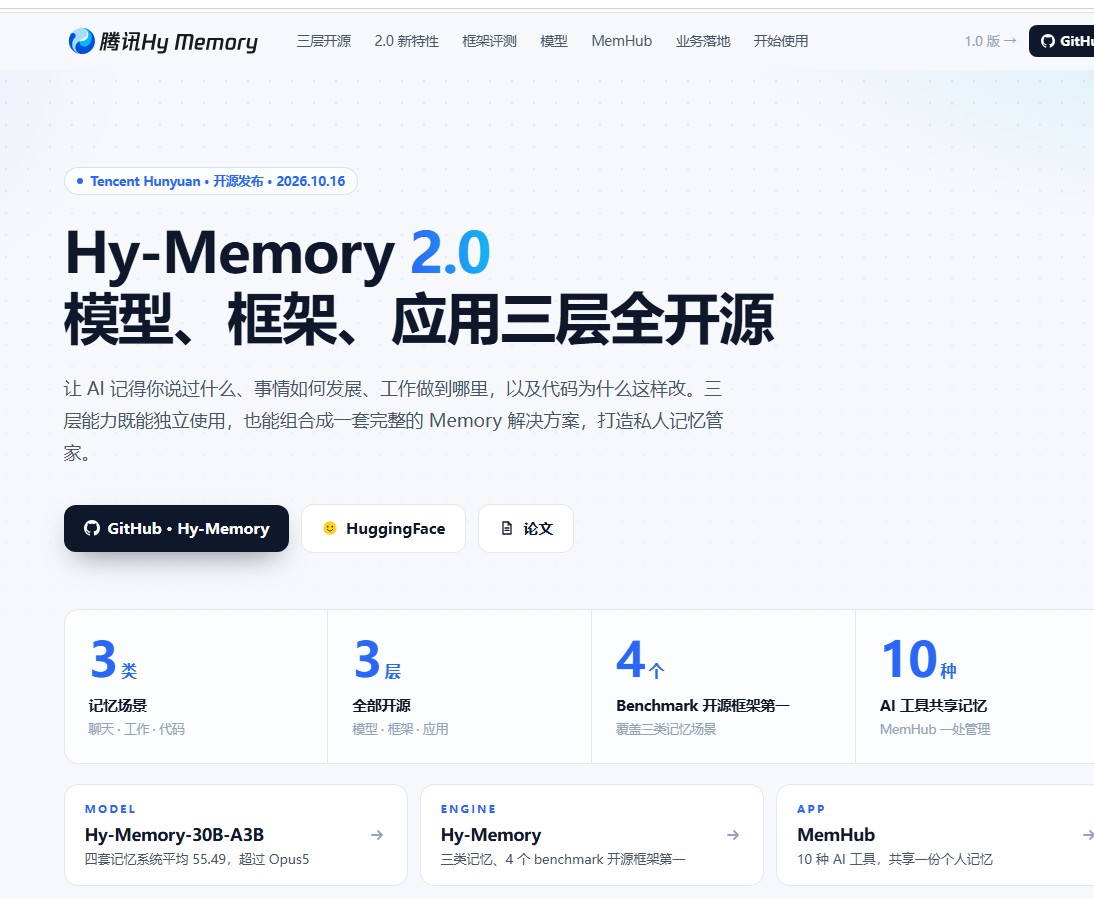
10 月 16 日,腾讯混元把智能体记忆框架 Hy Memory 升级到 2.0,并一次性开源了三层能力:专用模型、记忆框架和 MemHub 应用。三层既可以单独取用,也可以拼成一套完整的 Agent 长期记忆方案。
三层能力拆开看
模型层:Hy-Memory-30B-A3B
这是一只专门为"读写记忆"训练的模型,总参数 30B,采用 MoE 架构,每次推理只激活约 3B 参数。它不做通用推理,只负责从对话里抽事实、更新实体关系、沉淀用户画像,不挤占主模型的推理资源。
它的评测成绩值得单独记一笔:在四套记忆系统的评测框架上,宏观平均得分 55.49%,高于 Claude Opus 5 的 54.62%;换到它没见过的 EverMemOS 框架上,56.89 对 54.04,差距反而更大。和同架构基座 Qwen3-30B-A3B 的 44.37 分相比,提升约 11 分。
需要说明的是,这些数字基于固定的 20% 基准子样本,跨框架可比性要谨慎看待。
框架层:Hy Memory 框架
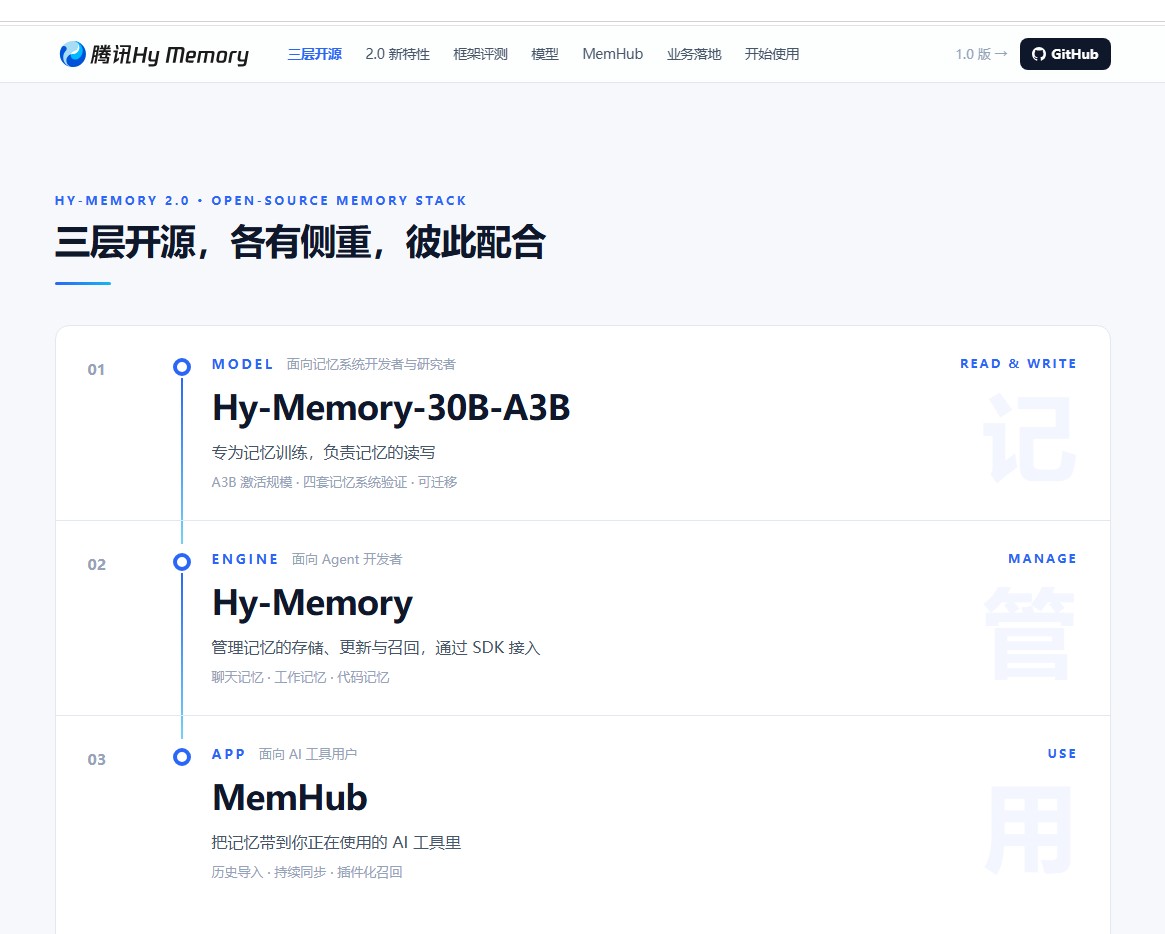
框架负责定义记忆的完整生命周期,覆盖聊天、工作、代码三类记忆的存储、更新与召回,开发者通过 SDK 就能接入自己的 Agent。腾讯方面表示,这是业界首个同时提出工作记忆与代码记忆的记忆框架。
记忆流转有四个环节:写入与提炼(把非结构化对话变成原子化事实)、动态更新与遗忘(用户状态变了,旧的矛盾记忆会被降权或覆盖)、多路检索(语义向量、关键词、关系图谱一起召回)、精准注入(把相关记忆放进提示词,而不是把全文倒进去)。
应用层:MemHub
MemHub 是一个本地记忆管理应用,提供 CLI 和 Mac 端 APP 两种用法。授权关联应用后,它能导入各工具的历史会话,沉淀为本地记忆,之后新产生的会话实时同步进同一份记忆。它支持以插件形式一键接入 AI 工具,目前覆盖 WorkBuddy、Cursor、Codex、Pi、Qwen Code、Hermes、DeepSeek Harness 和 OpenCode 等 10 种工具,商业编程工具和开源 Agent 都有。
2.0 新增的两块记忆
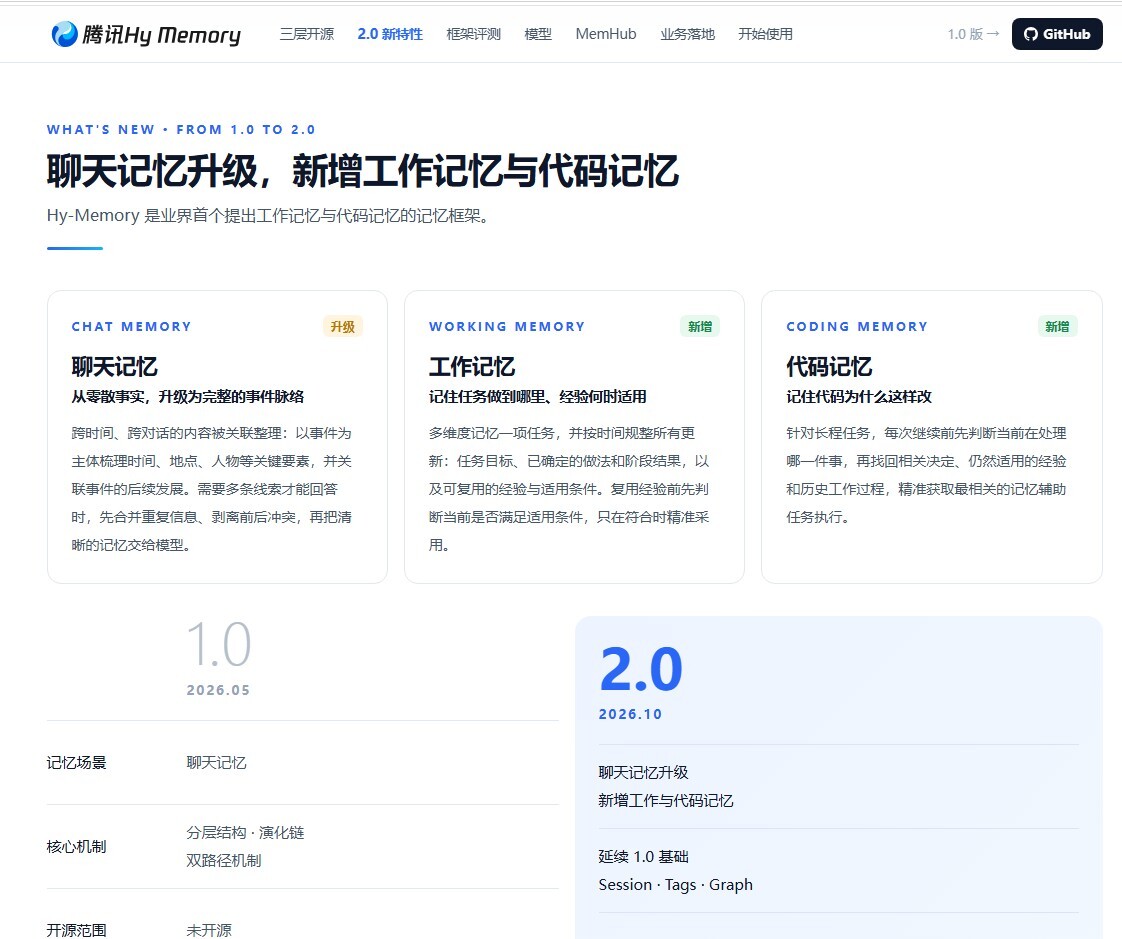
与 1.0 相比,2.0 最大的变化是在聊天记忆之外,补上了工作记忆和代码记忆。
聊天记忆从零散事实升级为完整事件脉络。它能把跨时间、跨对话的分散内容,以事件为主体梳理出时间、地点、人物等关键要素;遇到需要结合多条线索回答的问题时,会先合并重复信息、剥离前后冲突,再把清晰记忆交给模型。
工作记忆和代码记忆按多个维度记忆一项任务,按时间规整所有信息更新,包含任务目标、已确定的做法和阶段结果,以及可复用的经验与适用条件。复用经验前会先判断当前是否符合适用条件,符合才精准调用。长程任务重新开启前,系统会先判断当前在处理哪一件事,再找回相关决定、仍然适用的经验和历史工作过程。
数据表现
- 工作记忆:MemoryArena 旅行规划与组合购物平均分 55.31%,领先次优的 EverOS 10.2 个百分点(Simple RAG 41.22、Mem0 38.78、MemOS 37.30)
- 代码记忆:CodeMemoryBench 代码问答准确率 64.2%、任务解决率 35.6%;SWE-ContextBench 任务解决率 28.3%,高于 MemOS 和 Mem0 的 25.3%
- 聊天记忆:LoCoMo 准确率 72.6%(EverOS 71.9%),每题召回 token 从 1159 降到 703,减少 39.3%
已经在内部跑起来了
目前 Hy Memory 已在腾讯内部金融、资讯、知识管理、办公 Agent、社交娱乐和游戏等领域的多个业务中使用。
几个能看到的真实数据:自选股业务接入后,多跳召回率从 50% 升至 90%,整体通过率由 64% 提升至 81%;iWiki 仅用召回记忆作答,正确率比喂完整原文还高 48.6%。
技术底座与开源方式
架构上采用快慢双系统认知设计,结合分层记忆、向量检索和知识图谱。存储后端可插拔,向量库可选 ChromaDB、Qdrant 或 FAISS,图库可选 Kuzu 或 Neo4j,关系库用 SQLite,部署环境不同就能换不同方案。
时间线也很清晰:模型权重 10 月 15 日上线 Hugging Face(tencent/Hy-Memory-30B-A3B),框架包同日发布到 PyPI(版本 2.0.2,pip install hy-memory),SDK 与 MemHub 代码随后在 GitHub 的 Tencent-Hunyuan/Hy-Memory 仓库开源。1.0 版本今年 5 月发布,2.0 相关论文已被 EMNLP 2026 接收。
几点观察
这次开源最值得注意的,是把记忆从"模型附带的软能力"变成"可独立部署的基础设施"。开发者能只换模型,或只接框架,甚至直接用 MemHub 把现有工具的记忆打通,而不必重写整套系统。
当然,长期记忆也有代价:持久化意味着敏感数据会长期留存,多租户或强合规场景下,身份隔离、脱敏、按时间的自动销毁、被遗忘权的单条擦除都必须提前设计。记忆不是存得越多越好,把噪声一起记住,只会让召回越来越差。
从"每次从零聊"到"跨工具记人话、记决策、记代码为什么这么改",Hy Memory 2.0 走的是一条务实路线。它不追求参数上的热闹,而是想把 Agent 真正变成能陪你走长路的助手。