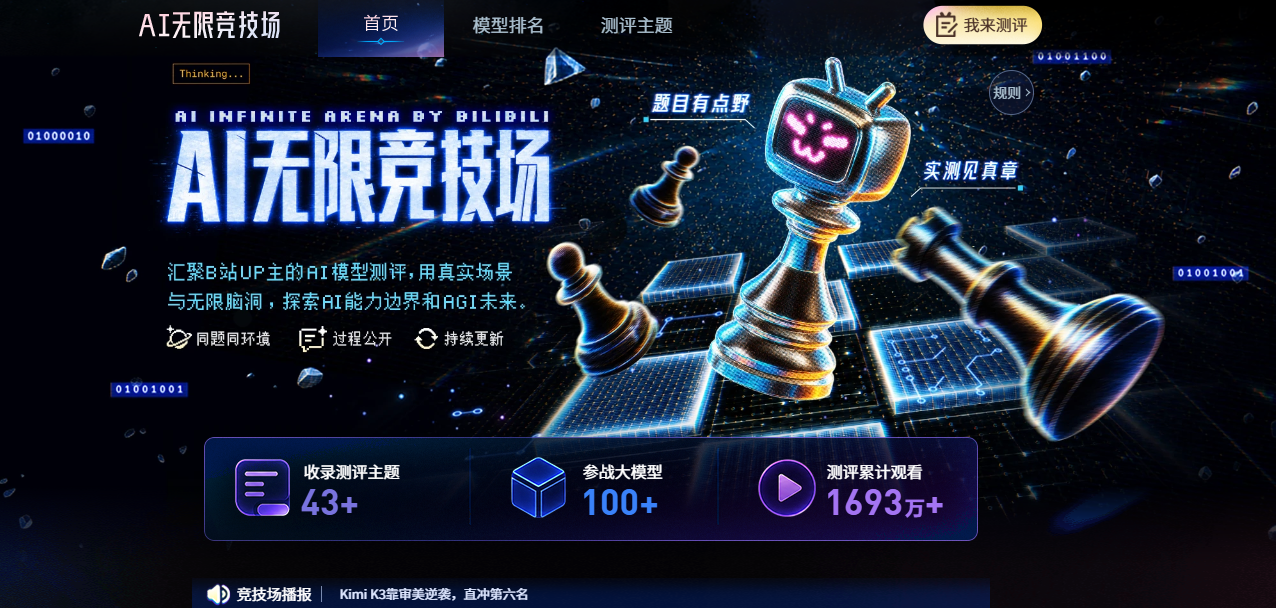
据B站官方及DoNews 等多家媒体 9 月 20 日消息,B 站正式上线「AI 无限竞技场」大模型测评榜,同步公布首期模型排行榜。在首轮测评中,GPT-6 Astra 在 10 个 UP 主测评中拿下榜首,打败 GLM-5.3 获得“榜首次数冠军”;前五名中,国产大模型占据1席,展现出强劲竞争力。
榜单地址: https://www.bilibili.com/blackboard/era/aiarena.html?bsource=market_aiarena_sns_02
为什么是 B 站来做这件事?
过去一年,B 站 AI 生态迎来爆发式增长。
公开信息显示,B 站 AI 知识内容消费时长同比增长 72%,月均观看 AI 内容的用户超过 1.9 亿。从模型发布讨论到使用教程分享,从技术测评到问题求助,围绕人工智能的创作生态已形成完整链条。
当模型迭代速度超越传统榜单更新频率时,将评测权交给真实用户群体,反而更能直观反映模型在实际应用中的表现差异。
B 站通过此举试图构建一个由社区生态驱动的大模型评价体系,为技术落地提供更具参考价值的用户视角。
不设命题限制,用真实工作流说话
与传统跑分评测不同,B 站「AI 无限竞技场」不设主题或测评维度限制——来自科技、教育、娱乐等不同分区的 UP 主以真实工作流、专业应用、趣味脑洞等自主命题,在同题 PK 中直观呈现各模型的实际表现差异。
测评者既会设计“用 AI 生成完整游戏脚本”这类复杂任务,也会设置“用方言描述需求并获取解决方案”等趣味挑战。目前已涌现出“屎山代码修复挑战”“模拟交易谁是搞钱王”“AI 媒婆竞争上岗”等脑洞大开的测评主题。
首期榜单涵盖 DeepSeek、Kimi、ChatGPT、Claude、Gemini、豆包、千问、Hy、MiniMax 等国内外主流模型的对比测评,排名实时更新,并持续面向全站 UP 主开放报名。

首期榜单:GPT-6 Astra 领跑,国产模型强势入围
从首期公布的排行榜来看,GPT-6 Astra 以综合表现登顶榜首,同时获得“登顶次数最多”的称号,领先于 GLM-5.3 等竞争对手。值得注意的是,前五名中有三个席位被国产大模型占据,显示出国内研发团队在人工智能领域的强劲竞争力。
榜单排名依据各模型在测评主题中获得榜首的次数,由高到低排列。随着更多测评案例加入,这些来自真实场景的样本测试,将让模型能力得到更充分检验,也为用户了解 AI 能力边界提供更全面的内容视角。
社区驱动测评,正在重塑大模型评价标准
这种由用户驱动的开放式测评模式,正在重塑 AI 大模型的评价标准体系。不同领域的需求碰撞出丰富的测评维度——从编程助手到创意生成工具,从学术研究辅助到日常办公提效,每个场景都是对模型能力的一次真实拷问。
B 站官方表示,竞技场排名将会实时更新,并持续面向全站 UP 主开放报名。随着更多测评案例加入,这些来自真实场景的样本测试,将让模型能力得到更充分检验,也为用户了解 AI 能力边界提供更全面的内容视角。
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: