9月20日,阶跃星辰正式发布并全量开放新一代旗舰基座模型 Step 5 Preview。该模型采用稀疏 MoE 架构,总参数量 600B,每次仅激活 27B,支持 100 万 Token 上下文窗口,原生支持文本与视觉输入。API 和 Studio 即日起全量开放,完整模型权重将于 10 月 15 日开源释放。
模型官网:阶跃星辰官网
一、模型规格:600B MoE,激活仅 27B
Step 5 Preview 采用“窄而深”的架构设计,没有一味增加网络宽度,而是选择提升层数。
核心规格如下:
| 指标 | 参数 |
|---|---|
| 架构 | 稀疏 MoE |
| 总参数量 | 600B |
| 激活参数 | 27B |
| 上下文窗口 | 1M Token |
| 输入模态 | 文本、图像 |
| 输出模态 | 文本 模型重点面向 AI 编程、软件工程、专业知识工作、金融分析等真实世界 Agentic 任务场景。 |
二、性能表现:AA指数44分,与K3 Max持平
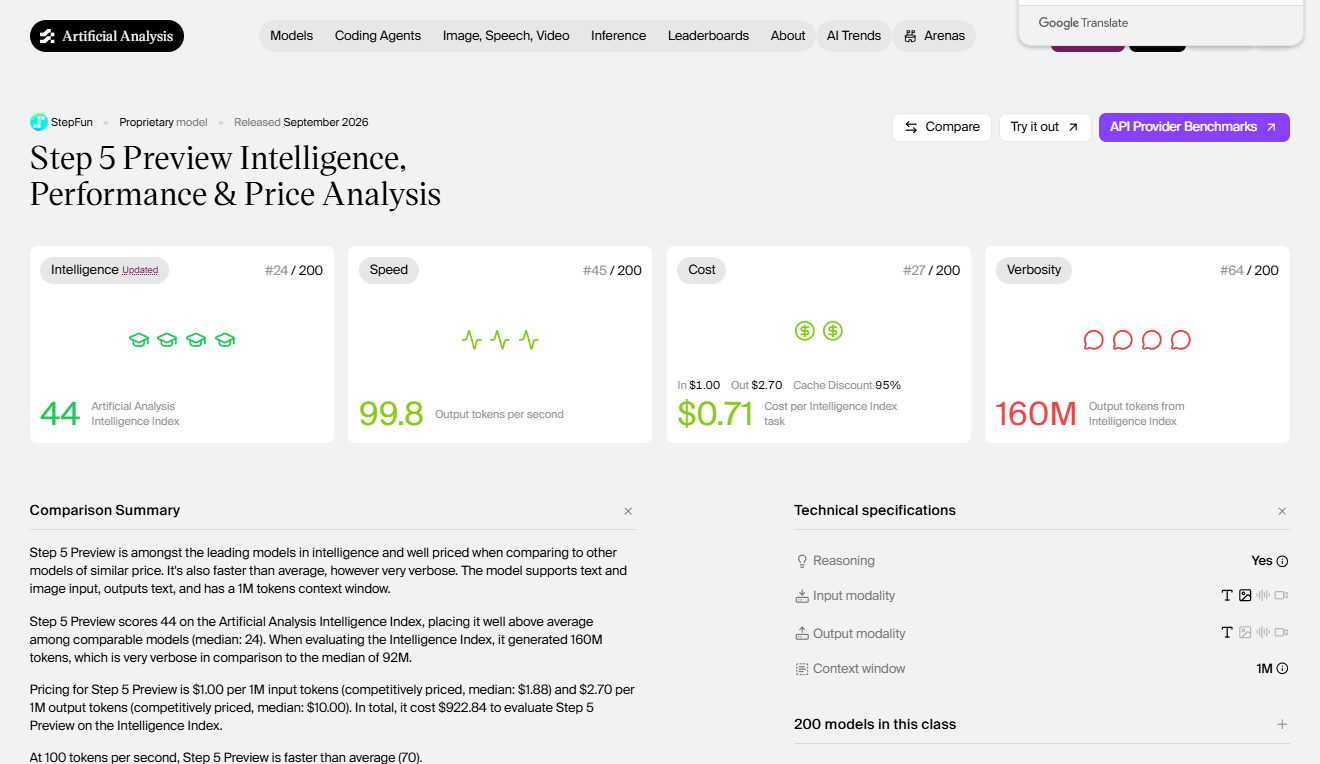
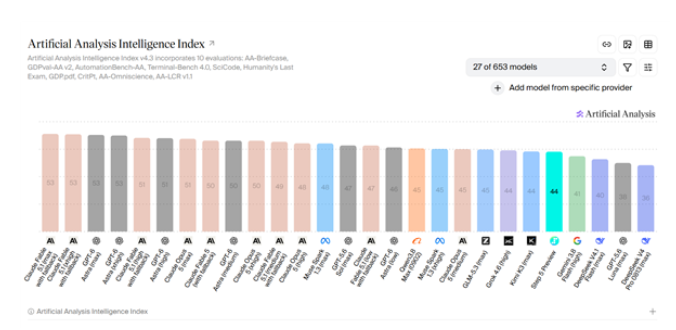
在 Artificial Analysis Intelligence Index v4.3 中,Step 5 Preview 得分 44 分,与参数量达 2.8 万亿的 Kimi K3 Max 持平,位列全球开源模型前三。该指数涵盖 AA-Briefcase、GDPval-AA v2、Terminal-Bench 4.0、SciCode、Humanity's Last Exam 等 10 项评测。
更值得关注的是成本效率。AA 数据显示,Step 5 Preview 每项 Intelligence Index 任务的成本为 0.71 美元,而 Kimi K3 Max 为 2 美元,成本降至约三分之一。在输出速度方面,Step 5 Preview 达到约 100 Token/s,明显快于 Kimi K3 Max 的约 40 Token/s。
不过,AA 也指出该模型非常冗长(very verbose)——在 Intelligence Index 评估中产生了 1.6 亿输出 Token,远高于中位数的 9000 万。这意味着虽然单 Token 价格有优势,但在实际任务中的总 Token 消耗可能偏高。
三、长任务能力:连续24小时自主迭代
Step 5 Preview 最引人注目的能力之一是其长程自主任务执行表现。官方披露了两个 24 小时量级的实验案例:
案例一:自主优化 H100 GPU 内核
Step 5 Preview 在单张 NVIDIA H100 上 自主运行约 22 小时,自行修改代码、运行测试、比较结果并持续迭代,最终将峰值性能提升至 508 TFLOPS。同一实验中,Claude Opus 5 的达到值为 493 TFLOPS。
案例二:自主设计后训练数据
在另一个 24 小时实验中,Step 5 Preview 自主设计后训练数据,将 Qwen3-30B-A3B 在 AIME24 数学推理基准上的准确率从 53.3% 提升至 60%,与 Claude Opus 5 持平,同时消耗的标注 Token 更少。
这两个案例的意义在于:模型不再只是被动执行指令,而是具备了在无人干预下持续迭代、自我优化的能力。阶跃将此称为“智能效率的帕累托前沿”——在能力、成本和效率之间寻找最优平衡。
四、定价与优惠:新用户最长可白嫖75天
API定价
Step 5 Preview 的 API 定价为:输入 7 元/百万 Token,输出 18 元/百万 Token,缓存命中 0.35 元/百万 Token。以美元计,约为输入 $1.00/百万 Token、输出 $2.70/百万 Token。
套餐体系
阶跃提供多档 Step Plan 套餐:
| 档位 | 月费 | Credits 额度 |
|---|---|---|
| Flash Mini | ¥49 | 400M |
| Flash Plus | ¥99 | 1600M |
| Flash Pro | ¥199 | 8000M |
| Flash Max | ¥699 | 40000M |
新用户福利
官方同步开启了力度不小的推广活动:新用户注册即送 99 元套餐,登录得 15 天,完成首次调用再得 15 天;每邀请 1 位好友注册再获 15 天,累计最高 45 天,总福利可达 75 天。
五、实际体验:有惊喜,也有代价
从社区反馈和媒体实测来看,Step 5 Preview 呈现出“能力跃升但速度承压”的特征。
正向评价方面,爱范儿实测显示,Step 5 Preview 在 Three.js 游戏开发、网页操作系统还原、3D 资产生成等任务中表现相当亮眼,界面完整度和功能衔接甚至优于 DeepSeek V4.1 Flash。官方还展示了该模型将一块 ESP32-S3 开发板改造成 Vibe Coding 键盘的案例,模型连续执行超过 3 小时,自主访问串口、调用摄像头并根据真实设备返回的状态持续调试代码。
局限与代价方面,AA 的测试数据显示,Step 5 Preview 的首个回答 Token 延迟约 23 秒,完整 benchmark 任务平均耗时超过 12 分钟。社区反馈也指出,实际使用速度不算快,若后续免费用户增多,速度可能进一步下滑。此外,有开发者评价其整体能力“与 DeepSeek V4.1 Flash 接近”,想真正持平 K3 并不容易。
六、行业定位:效率优先的路线选择
阶跃在官方发布中明确阐释了其技术路线逻辑:过去大模型 Scaling 的核心是用更多计算换更强智能,但随着模型规模和任务复杂度增长,计算成本同步放大,下一阶段的关键是提升 “计算转化为智能的效率”。从 Step 3.5 Flash、Step 3.7 Flash 到 Step 5 Preview,阶跃连续三代基座模型都在追问同一个问题。
Step 5 Preview 正是这一思路的产物——用 600B 参数而非万亿级参数,在 AA 指数上追平 2.8T 的 Kimi K3 Max,同时将单任务成本压到后者的三分之一。对于需要大规模调用模型执行长程 Agent 任务的开发者而言,这一成本结构具有相当的吸引力。
当然,冗长的输出习惯、较高的首 Token 延迟,以及在部分任务上仍与头部模型存在差距的现实,也提醒我们:Preview 版的意义在于验证方向,而非宣告终局。
更多信息请参阅阶跃星辰官方发布:阶跃星辰开放平台评测页面:artificialanalysis.ai/models/step-5
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: