9 月 18 日,阿里千问正式上线新一代原生全模态模型 Qwen3.8-Omni-Flash。该模型支持文本、图像、音频与视频四种输入模态,上下文窗口扩展至 1M Token,并原生支持最长 1 小时连续音视频输入。目前已在千问 AI 平台和阿里云百炼开放体验。
值得注意的是,该模型权重尚未公开,当前仅通过 API 提供服务。

一、从“能理解”到“能干活”:核心目标升级
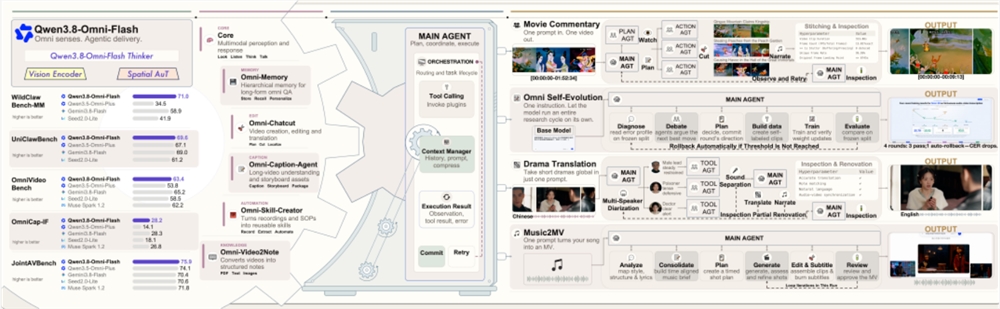
Qwen3.8-Omni-Flash 的核心目标是提升模型在真实生产力场景中的 Agent 能力,推动全模态模型从“理解全模态内容”进一步走向“规划任务、调用工具并完成创作”。
在延续此前编程、文本知识工作与 GUI 操作等通用 Agentic 能力的基础上,这一代模型着重拓展了以音视频为核心的 Agentic 应用,覆盖视频剪辑、MV 创作、影视制作与解说、音视频转图文摘要及音视频对话等需综合处理多模态内容的工作流。用官方的话来说,这是“耳聪目明,办事得力”。
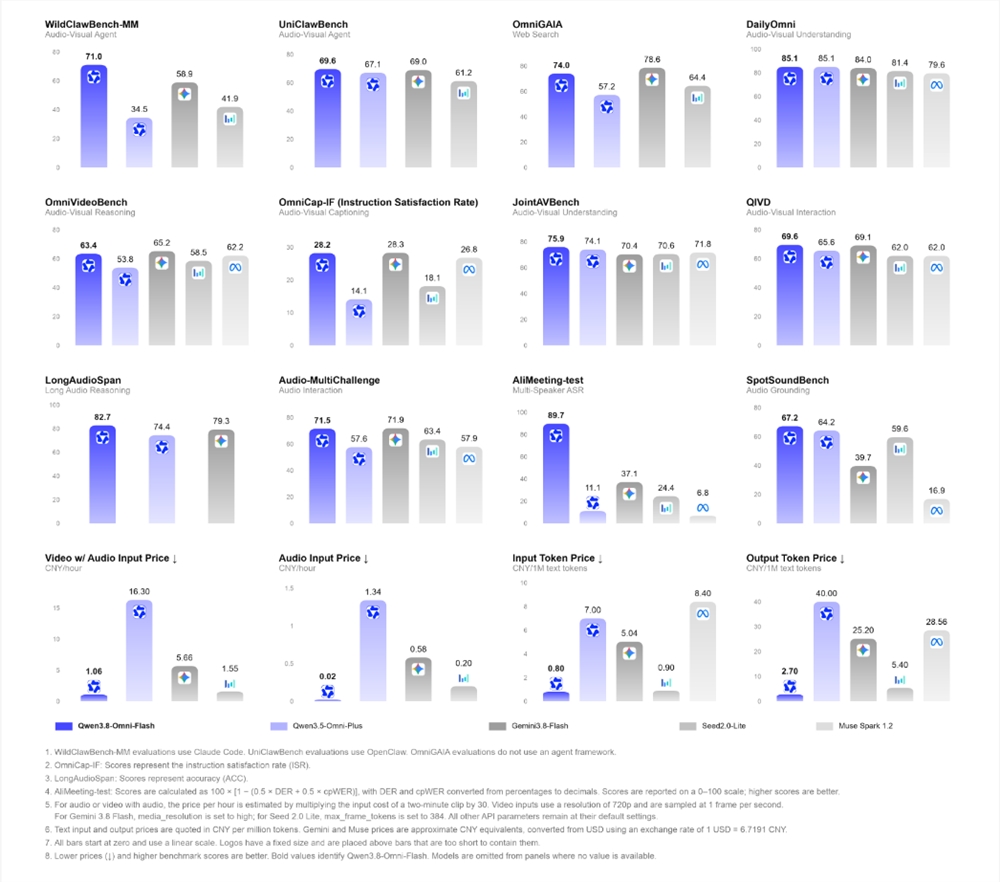
二、性能表现:30 项评测平均提升超 26%
在累计 30 项评测中,Qwen3.8-Omni-Flash 较上一代 Qwen3.5-Omni-Plus 平均得分提升超过 26%。
音视频 Agent 与长程任务
| 基准测试 | 提升幅度 | 说明 |
|---|---|---|
| WildClawBench-MM | +36.5 分 | 音视频 Agent 综合能力 |
| AgenticVBench | +22.3 分 | Agentic 视觉理解 |
| UniClawBench | 69.6 分 | 长程任务 |
基础能力
| 基准测试 | 提升幅度 |
|---|---|
| LongAudioSpan(长音频理解) | +8.3 分 |
| OmniVideoBench(音视频协同推理) | +9.6 分 |
| OmniCap-IF CSR / ISR(视频描述指令跟随) | +8.5 / +14.1 分 其中,多说话人会议转录基准 AliMeeting 表现尤为突出:DER(说话人分离错误率)与 cpWER(拼接字符错误率)从上一代的 88.11 / 89.61 骤降至 3.35 / 17.18。 官方表示,通过扩展数据、上下文与 Agentic 环境,该模型的音视频能力接近 Gemini 3.8 Flash,音频能力整体超过后者。 |
三、定价:按“每小时”重新定义多模态成本
Qwen3.8-Omni-Flash 的定价策略是此次发布中最具冲击力的部分:
- API 每小时音频输入价格降幅超过 98%
- API 每小时音视频输入价格降幅超过 93%
- 以 Token 口径计算,百万 Token 图文音视频输入价格降至 0.8 元。
- 需要说明的是,官方价格计算口径为:音频或音视频每小时价格按 2 分钟素材的输入成本 ×30 估算,音视频采用 720p、1fps 规格。
四、生态配套:Qwen-MM-Plugins 与 Qwen-Live Harness
为支撑长程工作流与实时交互,千问同步扩展了 Qwen-MM-Plugins 并开源 Qwen-Live Harness。
Qwen-MM-Plugins:面向 Agent Harness 的多模态插件套件,可安装至 Claude Code、Codex、Gemini CLI、Qwen Code 等主流 Agent 环境,赋予其图像、音频、长视频处理及视频编辑能力。其中 Video2Note 可将数小时视频内容生成图文对应的 PDF 笔记,Omni Skill Creator 可从操作演示中提炼标准作业流程并转化为可复用的 Agent Skill。
Qwen-Live Harness:更像一个实时调度层。用户可直接与实时全模态模型对话,再将复杂任务交给后台 Agent 持续执行,完成后主动返回结果。
一个值得关注的技术细节是Agentic Understanding 模式带来的效率提升。在 OmniVideoBench 上,该模式下准确率从 63.4 提升至 67.8,同时单次查询的 Token 消耗从 145,736 降至 79,117,降幅约 45.7%。这意味着模型不再从头到尾逐帧处理长视频,而是从问题出发、由粗到细多轮取证,自主决定该看什么听什么。
五、Realtime 版本:首个支持“听声辨位”的全模态大模型
同步推出的 Qwen3.8-Omni-Flash-Realtime 面向持续低延迟交互,支持 WebSocket 和 WebRTC,可在音视频流输入过程中同步完成感知与响应。
其最突出的特点是首个支持“听声辨位”的全模态大模型:融合空间声音与视觉信息,判断声源方向和距离。该版本适用于口语陪练、空间音频感知及智能客服等场景。
六、模型自进化:12小时优化小模型方言识别
此次发布中一个颇具前瞻性的实验是将模型推向研发环节本身。
团队让 Qwen3.8-Omni-Flash 在 12 小时内自主完成评测集选择、数据构建与 4 轮迭代,累计构建 3,413 条训练数据,将 Qwen2.5-Omni-3B 的四川话识别字符错误率从 25.79% 降至 15.30%,相对下降约 40.7%。
这一实验展示了前沿模型作为“模型优化器”的潜力——不仅是执行任务的工具,还能参与到模型自身的迭代过程中。
Qwen3.8-Omni-Flash 以 1M 上下文、四模态原生输入、30 项评测平均提升超 26%、音视频 API 价格暴降超 90% 的组合,将全模态模型从“感知”推向了“执行”。与同步推出的 Realtime 版本和开源生态工具一起,这套组合拳标志着音视频正在从模型的感知输入,进一步成为 Agent 理解环境、开展推理并执行任务的核心载体。
更多信息请参阅:
Qwen官方博客:qwen.ai/blog?id=qwen3.8-omni-flash
千问AI平台:qianwenai.com
AITOP100-AI资讯频道将持续关注AI行业新闻资讯消息,带来最新AI内容讯息。
想了解AITOP100平台其它版块的内容,请点击下方超链接查看
AI创作大赛 | AI活动 | AI工具集 | AI资讯专区 | AI小说
AITOP100平台官方交流社群二维码: