9 月 14 日,在 2026 浦江创新论坛的类脑具身智能分论坛上,具脑磐石发布了它的第一代类脑认知世界模型,叫 Cog-WM 1.0。
按官方的说法,这是全球首个基于成体系类脑神经机制研发的类脑隐空间预测世界模型。话有点绕,落到具体能力上就是一句:机器人不用预建地图、不用海量数据,也能在陌生环境里自主规划、语义导航,再顺手完成操作任务。
为什么说这条路不一样
过去做具身智能,主流思路是"用更多数据补更多场景"。数据不够就采,泛化不行就加参数。这套办法有上限,具脑磐石的判断是,把数据和参数都扩大十倍,换不来机器人对物理世界的真正理解。
所以他们换了个方向,回到人脑。
人过马路不会去精确测量每辆车的速度和距离,扫一眼周边就够了。这种能力在认知科学里叫主动推理,也叫心智模型。具脑磐石想做的,就是把脑科学里已经验证过的机制,翻译成可计算的算法和架构。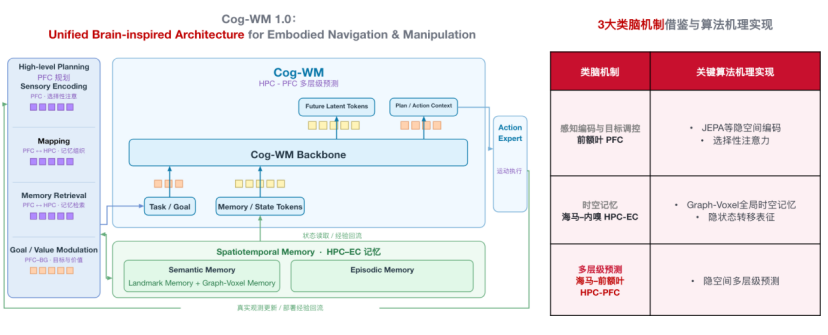
三套机制,不是打补丁
Cog-WM 1.0 的底层思路,是借鉴人脑认知地图里"组织记忆、选择性更新、预测后续状态"的做法,再结合 JEPA(联合嵌入预测架构),在抽象特征空间里学"未来会怎么变"。
它看的不是像素怎么变,而是跟任务有关的空间和状态怎么变。支撑这个思路的,是三套成体系的机制:
第一,感知编码与目标调控。在隐空间而不是像素层面重建世界,只预测对决策有用的抽象表征,学习目标小了,数据需求自然小。
第二,时空记忆,内容与结构分离。空间结构可以跨任务复用,学会"房间大概长什么样"之后,换个房间不用重新学。靠惊异更新,系统只对"意外"投入学习,不重复消化已知信息。
第三,隐空间多层级预测。跨时空尺度分层预测,支撑陌生环境里的长程探索。
这三套机制在导航和操作两个任务域上都做了验证,方法已经通过 arXiv 论文公开。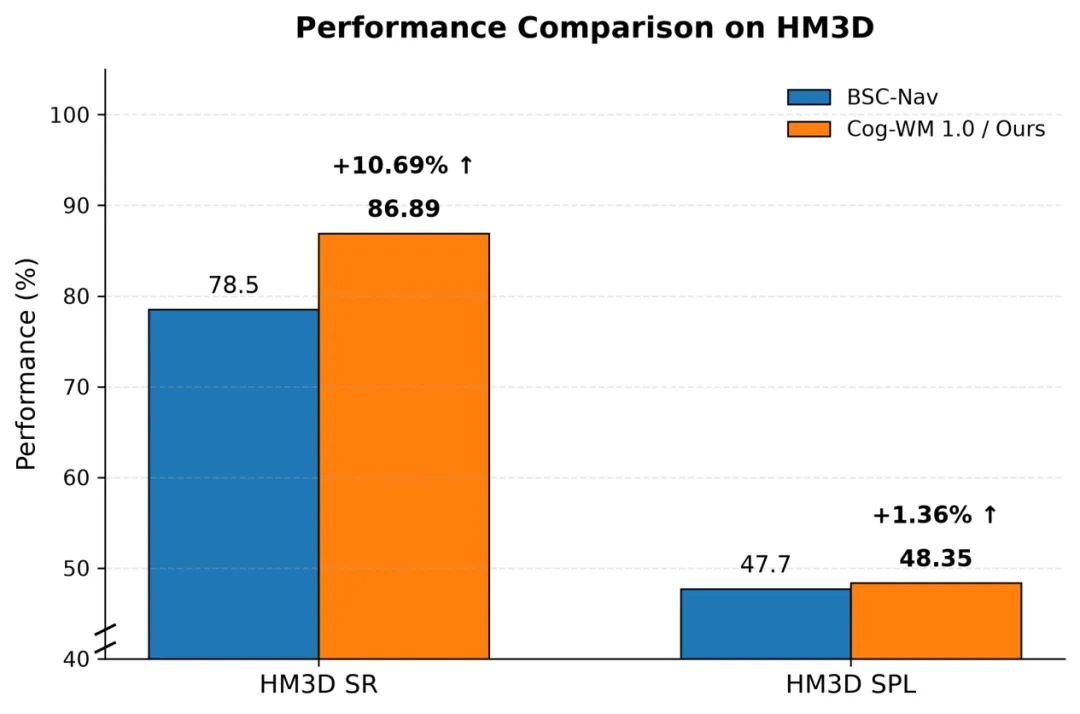
导航:不建图,也能找到沙发
导航分支叫 Cog-WM Nav 1.0。它的做法是把空间记忆和前瞻预测绑在一起:结合任务目标与既有环境记忆,预测后续的空间表征和探索子目标,再决定下一步往哪走。
在 HM3D-ObjectNav 子集上,导航成功率从 78.50% 提到了 86.89%,比认知地图导航的 SOTA 基线 BSC-Nav 相对提升 10.69%,路径效率也从 47.70 提到 48.35。关键前提是,全程没有预置地图先验。
它已经在四足机器人上部署,用在巡检、巡逻场景的客户现场,也适配过轮式人形机器人。
操作:三大基准都超过海量数据预训练的 SOTA
操作分支叫 Cog-WM Manip 1.0。连续操作里每一步都会改变后续条件,它用多时间尺度预测,让模型同时学近期动作后果和后续任务状态,再引入价值引导的经验学习。
在统一复现协议下,它在三大主流操作基准上都超过了用海量数据预训练的 π0.5:LIBERO 98.2%、LIBERO-Plus 84.6%、RoboTwin 2.0 Hard 43.2%(相对 π0.5 提升 16.2%)。
更有说服力的是消融实验。能力是一层层叠出来的:纯策略 80.0%,加上局部预测 81.6%,再加多时域预测 82.0%,完整方法 84.6%。每一层提升都对应一个明确机制。光照变化、视角迁移、背景纹理改变这些扰动条件下,它也能稳定完成任务。
一家刚满一年的公司
具脑磐石 2025 年成立,创始人朱森华被称为"华为具身大脑一号位",做过华为云 AI 算法创新 Lab 主任,主导过盘古具身大模型,博士毕业于宾夕法尼亚大学认知神经科学专业。今年 5 月,公司刚完成一轮亿元级融资。
团队给自己的定位是国内唯一对标杨立昆 AMI Lab 技术愿景的团队,走的是一条少有人走的路。
写在最后
Cog-WM 1.0 的价值,不在某个单点的指标,而在它把"低数据、高泛化"这条路线第一次放到了公开基准上去验证。
当机器人不再读死地图,而是像人一样长记性,具身智能才算真正开始。这件事现在有了一个可检验的起点。