R1-Omni:多模态情感识别新突破
3月11日,通义实验室团队宣布开源R1-Omni模型,标志着全模态模型发展迎来重要进展。该模型巧妙地融合了强化学习与可验证奖励(RLVR)方法,着重提升模型在多模态情感识别任务中的深度推理能力和广泛的泛化性能。
R1-Omni的训练过程分为两个关键阶段。首先是冷启动阶段,研究团队采用包含580条视频数据的混合数据集进行精细微调,这些数据精选自Explainable Multimodal Emotion Reasoning(EMER)数据集和HumanOmni数据集。这一阶段的目的是为模型构建扎实的基础推理能力,确保其在进入后续的RLVR阶段之前,已经具备一定的多模态情感识别能力,从而保证整个训练过程的平稳性、高效率和稳定性。
RLVR阶段:强化学习优化
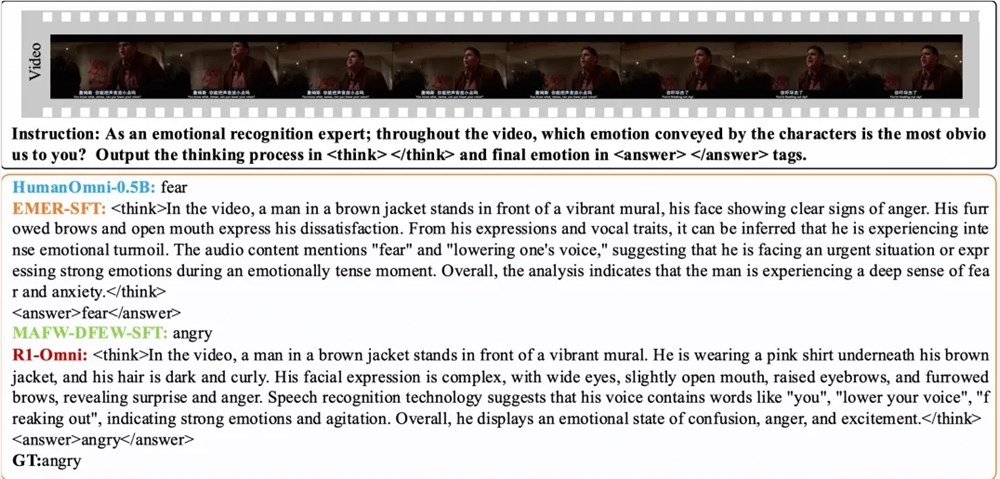
接下来,进入RLVR阶段,模型通过强化学习与可验证奖励机制进行深度优化。此阶段的核心在于策略模型和精心设计的奖励函数。策略模型负责处理由视频帧和音频流组成的多模态输入数据,并生成带有详细推理过程的候选响应,清晰展示了模型如何整合视觉和听觉信息,最终得出准确的情感预测。奖励函数的设计灵感来源于DeepSeek R1,它被划分为精确率奖励和格式奖励两部分,共同构成最终的综合奖励,既鼓励模型生成正确的预测结果,又确保输出的结构化和符合预设的格式规范。
卓越的实验结果
实验结果有力地证明了R1-Omni的卓越性能。在同分布测试集DFEW和MAFW上,与原始基线模型相比,R1-Omni的平均性能提升超过35%。更值得一提的是,与传统的有监督微调(SFT)模型相比,R1-Omni在未加权平均召回率(UAR)指标上实现了高达10%以上的显著提升。在不同分布测试集RAVDESS上,其加权平均召回率(WAR)和UAR均提升超过13%,充分展现出其强大的泛化能力。
此外,R1-Omni还拥有显著的透明性优势。借助RLVR方法,音频和视频信息在模型中的作用变得更加清晰可见,能够明确地展示各模态信息对于特定情绪判断的关键贡献,为深入理解模型决策过程和未来的研究方向提供了重要的参考依据。
通义实验室R1-Omni模型地址:【点击登陆】