🧠 一位ChatGPT元老的新赌注
创始人背景
Diogo Almeida,前OpenAI研究员,亲历RLHF、InstructGPT、ChatGPT、GPT-4从实验室走向大众的全过程。2024年在旧金山创立TypeSafe AI。
核心命题
“我花了多年时间研究让AI更擅长与人互动。但如果AI要从根本改变工作的完成方式,人不能是智慧唯一的消费者。”
DCVC合伙人点出关键:模型够不够聪明已不是最大问题,让开发者信任模型给出的判断、并可靠地大规模嵌入产品,才是真正的卡关点。
🎯 Jev是什么?不生成文字,只吐概率
命名双重典故
| 来源 | 含义 |
|---|---|
| System One | 借用康纳曼《快思慢想》:系统一=快速直觉,对标LLM的“系统二”缓慢推理 |
| Jevons | 经济学家杰文斯悖论:资源越便宜高效,人类反而用得越多。期望Jev因足够便宜而被塞进更多原本舍不得用AI的场景 |
运作机制:与LLM完全不同的范式
| 对比维度 | LLM | Jev |
|---|---|---|
| 输出方式 | 逐token生成,像打字 | 一次平行运算,直接输出结构化结果 |
| 答案格式 | 自由文本 | Schema预定义的型别化概率决策 |
| 输出原语 | 无限可能 | 仅三种:Choice(≤255选项选一)、Score(数值评分)、是非判断(附概率) |
| 可信度 | 难以校准 | 每个答案附校准信心分数,统计意义上可靠 |
| 训练方法 | RLHF / RLVR | 自研RLCD(校准决策强化学习) |
| 幻觉风险 | 存在 | 官方称输出被schema锁死,“不会产生幻觉” |
💡 信心分数的意义: 程序可据此自动决定——放行、转交人类复查、或调用推理模型二次验证。
📊 性能实测:快200倍,但不是万能
速度对比示范案例
| 模型 | 同一判断任务耗时 |
|---|---|
| Jev | 0.114秒 |
| GPT-5.6 Terra | 8.566秒 |
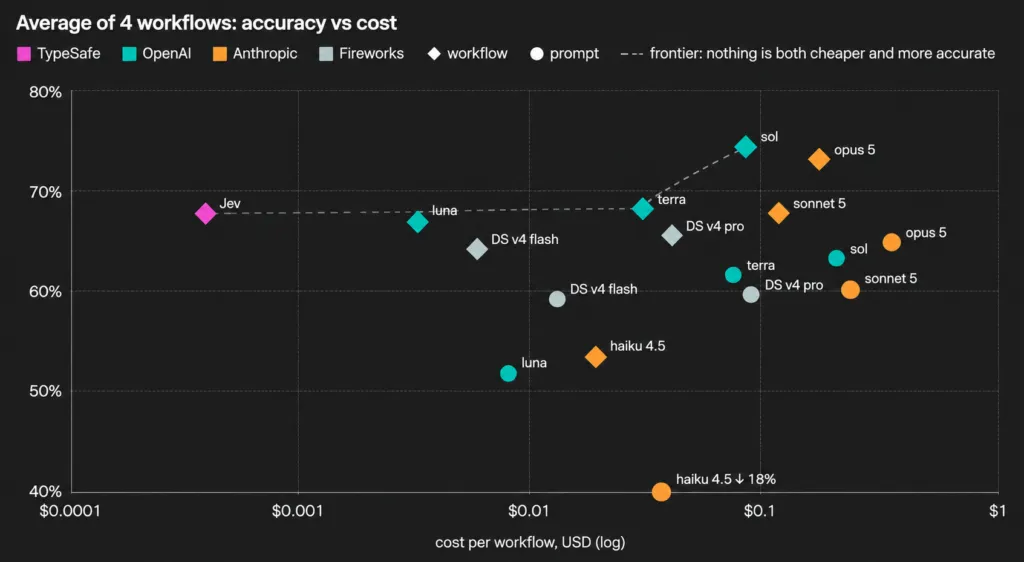
综合基准测试(vs GPT-6 Astra & Claude Fable 5.1均值)
- 最高快193.6倍
- 最高便宜444.6倍
- 智能水平与现有LLM“相近”
定价对比
| 模型 | 输入价格(/百万token) | 输出价格 |
|---|---|---|
| Jev | $0.042 | 免费 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| Claude Fable 5.1 | ~$10.00 | — |
TypeSafe称比Fable 5.1基本价便宜238倍。
⚠️ 必须认清的代价
- ❌ 不能聊天、不能写代码、不能解释判断理由
- ❌ 只接受文字输入,不支持图片/音频/视频
- ❌ 答案永远锁定在预定义选项内,无法跳出框架
- ❌ 校准分数是批量统计意义上的准确,不保证单次必对
📰 The Register评论: 拿“无幻觉”与LLM比较并不公平。结构化输出与自然语言本就是两套体系,没有幻觉空间≠模型更聪明。
🔧 真正适合Jev的场景
Jev的定位不是替代LLM,而是接管那些本该由程序判断、却因缺乏更好选项而被硬塞进LLM的工作:
- 请求分类与路由
- 发票处理 / 客服分流
- 资安警报筛选
- 大规模数据处理
- 审查AI Agent产出 / 抓越狱攻击
- 为LLM输出加一层护栏
🎮 极限演示: TypeSafe让Jev玩DOOM展示速度——每秒10次查询,一小时成本约7美元。
📌 当前状态与延伸阅读
⏳ Jev目前处于早期存取阶段,需在官网填写等候名单,尚未全面开放。
- 前情提要: ChatGPT捏造证词:美国律师被判藐视法庭开罚,谋杀案上诉被迫重来
- 背景补充: Anthropic宣布关闭Cowork模式并入Claude聊天,任务由AI自行判断